近日,摩尔线程全功能GPU可观测能力正式合入HUATUO(华佗)开源社区官方主线。此次合入标志着摩尔线程GPU正式融入开源可观测体系,首次在社区原生平台上实现device侧与host侧数据的协同定位。运维人员与开发者无需配置私有补丁,即可在同一时间线上实时掌握单机与集群GPU的运行状态,提升智算集群的运维效率与易用性。
背景:国产GPU规模化
运行的观测缺口
近两年,国产AI算力从可用性验证进入规模化部署阶段。算力与生态兼容决定能否用起来,稳定性、可观测性与故障场景下的快速根因定位,决定能否真正投入生产。其中,可观测是最容易也最迫切补齐的一环。
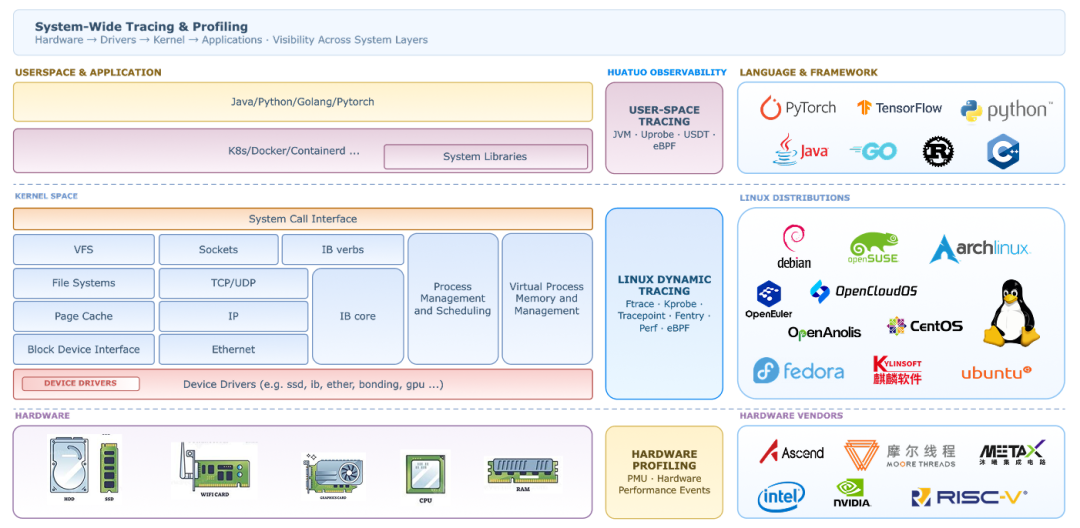
HUATUO(华佗)是由滴滴开源并依托CCF(中国计算机学会)孵化的操作系统深度可观测项目,专注为复杂云原生通用计算、AI计算及裸金属基础服务提供内核级深度观测能力。HUATUO致力于通过eBPF与内核动态追踪技术,提供涵盖操作系统内核及异构计算硬件的全栈可观测能力,核心成员由开源技术爱好者与基础技术研究者组成。
此前,HUATUO的观测视野主要集中在host与内核侧。然而,随着8卡、16卡甚至32卡成为单机常态,跨卡互联从PCIe升级为各家自研的高带宽互联技术,训练与推理异常往往不再发生在host端,而是直接落在device侧——显存吃紧、芯片过热、PCIe降级或跨卡链路异常已成为常见现象。传统的host侧信号(日志、调度、网络)只能间接推断,根因确认依赖各厂商自有CLI,排障流程零散且难以统一。
HUATUO全栈可观测能力
新增:摩尔线程GPU device
侧可观测能力
摩尔线程提交的PR #641为HUATUO引入了摩尔线程全功能GPU的device侧观测能力。该能力由原生集成的mthreads_gpu采集器实现:采集器调用摩尔线程官方MTML库读取GPU运行状态,将其转换为标准Prometheus指标,由HUATUO原生/metrics端点统一暴露,一次拉取即可获得全量数据,无需额外sidecar。
除芯片温度与利用率等基础健康数据外,该采集器重点增加了对MTLink跨卡互联以及PCIe协商速率与重传计数的采集,覆盖大规模智算集群在卡间互联与设备状态上的关键观测需求。
在工程实现上,采集器兼顾高并发拉取与系统自愈:仅将随时间变化的动态指标纳入高频轮询,多卡场景下并行拉取,采集开销不随卡数增加而线性膨胀;驱动或底层库偶发异常时,采集器按规则自动重连,保证观测链路持续稳定。
首批接入的指标覆盖设备基本信息、运行状态与互联通信三个方面:
▼ 基本信息类:设备型号、序列号、PCI/BIOS信息、显存规格等静态信息,可用于资产盘点与驱动版本核对。
▼ 运行状态类:芯片/显存温度、功耗、电压、电源上限、计算与显存利用率、显存总量与已用量、GPU/显存当前与最大频率、风扇转速与百分比、性能状态(P-state)、VPU总利用率与编解码利用率、VPU时钟。
▼ 互联通信类:PCIe当前与最大链路速率(GT/s)、当前与最大链路宽度(lane)、重传计数;MTLink每条链路的运行状态(DOWN/UP/DOWNGRADE)、机内互联规格(单链路带宽、链路数)。
以下指标在运维排查中较为常用,其含义如下:
▼ gpu_temperature_celsius:芯片核心温度。温度持续走高通常意味着散热异常或触发限频,是排查单卡吞吐下跌时的首要检查项。
▼ gpu_utilization_percent:GPU计算单元利用率。与memory_utilization_percent结合观察,可区分任务是算力受限还是在等待数据。
▼ memory_used_bytes / memory_total_bytes:显存压力指标。已用量接近总量时易触发OOM;与memory_temperature_celsius结合,可识别显存温度异常导致的隐性分配失败。
▼ pcie_link_speed_gt_per_sec / pcie_link_max_speed_gt_per_sec:PCIe当前协商速率与硬件最大速率。当前值持续低于最大值说明链路被降级,是多卡all-reduce变慢的常见根因。
▼ pcie_replay_total:PCIe物理层重传计数。持续上涨表明链路质量劣化(接触不良、信号衰减),可作为预测性维护的早期信号。
▼ mtlink_state:机内MTLink链路状态(按link label区分),取值0、1、2分别对应DOWN、UP、DOWNGRADE。任一链路由UP变为DOWNGRADE都应触发即时排查。
▼ fan_rpm / fan_speed_percent:风扇转速(按fan label区分)。长期为0或过低说明散热系统失效,可与gpu_temperature_celsius联动告警。
所有指标均携带gpu=<index>标签,多卡场景下可直接按设备筛选与聚合。完整指标列表见mthreads_gpu采集器说明。
配置部署:三步接入
mthreads_gpu采集器沿用HUATUO的配置方式,无需额外编译构建,按以下三步配置即可启用device侧可观测能力。
▼ 第一步:在全局配置的默认禁用列表中将mthreads_gpu移除。该采集器默认不启用,以避免在未安装驱动或库的环境中误启动。
▼ 第二步:在配置文件的Mthreads段中按需启用采集模块,配置项包括EnableHealth、EnablePCIe、EnableMTLink。
▼ 第三步,映射设备与依赖库:
• 容器环境:通过Docker/K8s挂载设备节点(/dev/dri/renderD、/dev/mtgpu.)与动态依赖库(libmtml.so);
• 裸机环境:直接运行,无需额外挂载操作。
配置完成后,HUATUO的/metrics端点将出现以mthreads_gpu_为前缀的指标系列,可与host侧指标置于同一时间线进行关联分析。
应用场景:从日常监控到根因定位
合入HUATUO官方主线后,mthreads_gpu采集器主要面向智算集群运维的三类场景:
▼ 大规模训练/推理集群的日常可观测:将GPU运行状态、PCIe链路及MTLink状态统一接入指标平台,与host侧指标对齐分析,替代以往用户各自运行CLI、自行解析输出的零散做法。
▼ 故障定位与根因排查:当训练或推理发生卡死、吞吐量(throughput)异常下跌、集合通信变慢时,可快速定位问题,直接给出判断方向——是GPU自身(温度/功耗)、机内互联(PCIe/MTLink),还是跨机网络。
▼ 容量规划与健康巡检:在Prometheus / Grafana上构建长期趋势看板,持续跟踪温度抖动、PCIe降速、物理层重传计数等早期信号,推动故障治理从“事后救火”前移至“事前预警”。
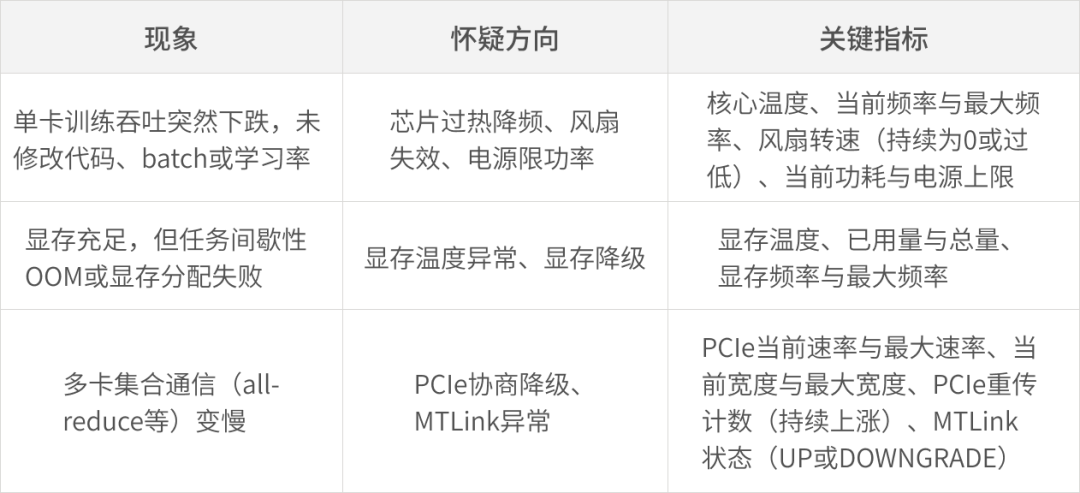
在实际排障中,无论是集群日常巡检,还是大模型训练中断后的急救排障,运维人员均可参照以下典型故障映射表进行快速推断:
未来规划:从指标监测到根因闭环
摩尔线程GPU融入开源可观测体系,让device侧与host侧数据在同一时间线上协同定位,为排障、巡检与容量规划提供统一的数据基础。
指标合入社区是摩尔线程与HUATUO合作的第一步。下一阶段,双方将围绕以下四个方向推进,把GPU侧可观测从“指标呈现”扩展到“事件、根因与端到端”:
- 异常事件实时上报:在指标之外增加事件流。温度阈值触发、风扇停转、PCIe降速、MTLink状态切换等异常,不再依赖指标扫描发现,而是以结构化事件实时上报,缩短告警响应时间。
- 线上持续profiling:打通底层性能分析工具链,支持在不重启生产服务的前提下完成线上轻量级性能定位,必要时按需拉起深度采样。
- 集群网络拓扑可观测:将MTLink机内互联与RDMA跨机网络的拓扑和性能数据接入HUATUO,使卡间与跨节点通信时延可以被直接观察。
- AI作业端到端Trace:将设备侧指标与上层AI框架(如PyTorch)、host侧调度上下文关联,从单卡指标扩展到大模型训练/推理作业的全链路Trace。
算力生态的发展离不开开源社区的协作。未来,摩尔线程将继续与HUATUO等开源项目合作,持续贡献可观测工具与能力,与开发者及社区伙伴一同打造更加稳定、易用的智算基础设施。
了解摩尔线程全功能GPU与HUATUO合作更多信息,请访问以下链接:
▼HUATUO文档中心
https://docs.huatuo.tech/zh/latest/
▼HUATUO GitHub仓库
https://github.com/ccfos/huatuo
▼摩尔线程GPU支持PR #641
https://github.com/ccfos/huatuo/pull/641
▼ 关于摩尔线程开发者
摩尔线程开发者是国产 GPU 创新企业摩尔线程专为技术爱好者和开发者打造的一站式服务平台。摩尔线程致力于构建一个技术共享和创新驱动的开发者生态服务体系,助力开发者实现技术突破,推动创新应用落地。