8月28日,腾讯上线并开源新一代旗舰大模型Hy4 preview,摩尔线程旗舰级AI训推一体智算卡MTT S5000于同日实现Day-0极速适配(开发者可通过模型镜像实现开箱体验)。这不仅展现了MUSA软件栈对前沿大模型演进的敏捷响应能力,也再次验证了国产全功能GPU承载超大参数、超长上下文前沿模型创新的坚实工程底座实力。
演示视频:Hy4 preview在双机16卡MTT S5000上的运行状态
▼ Hy4 preview开源地址:
https://huggingface.co/tencent/Hy4-preview
▼ 模型镜像体验地址:
registry.mthreads.com/presale/devtech/vllm_musa_hy4:v2.0
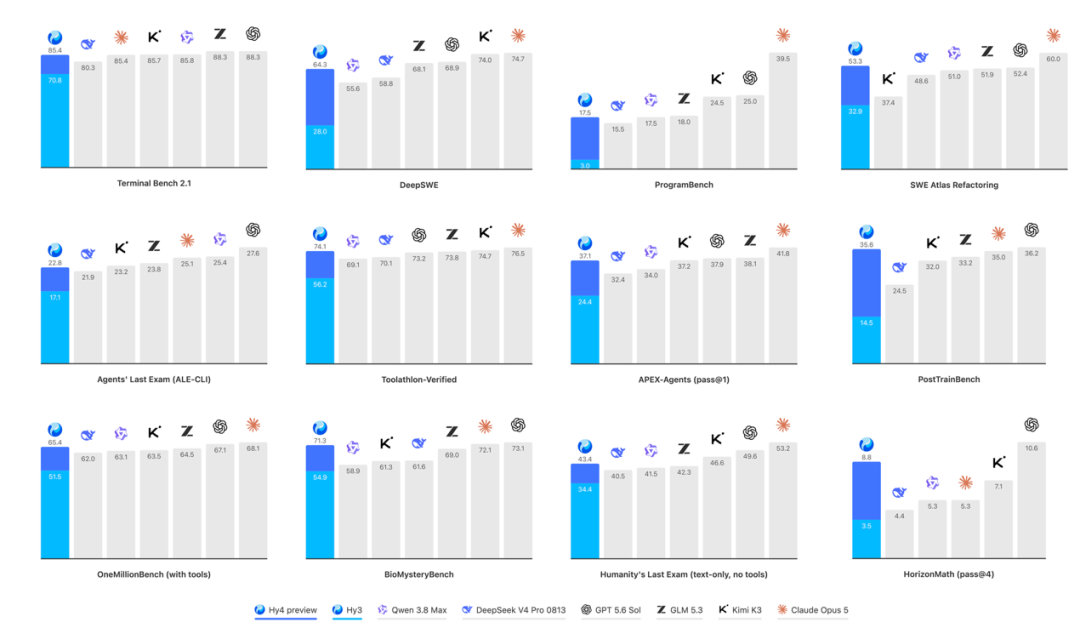
作为腾讯新一代旗舰开源模型,Hy4 preview总参数量770B,激活参数49B,支持 1M tokens 超长上下文。基于与腾讯内部软件工程、游戏、金融、安全等领域顶尖专家共建的高质量数据,模型在代码开发、办公分析、游戏构建、科学研究等真实生产力任务上实现显著跃升,覆盖长程开发规划与前端审美、复杂金融分析与跨文件协作、一句需求生成可玩原型、AI研发与基础科学求解等高价值场景,并持续与 CodeBuddy、WorkBuddy 等产品深度协同,优化真实场景下的用户体验。
针对Hy4 preview的核心能力特征,MTT S5000从硬件算力、软件栈到开源框架进行了全链路精准匹配与深度优化。
▼ 在模型架构层面,针对Hy4 preview采用的Gated MLA、DSA及Learnable Sink等注意力机制,摩尔线程在vLLM-MUSA中完成了模型结构、权重加载与稀疏注意力后端的完整适配,并打通支持Learnable Sink的稀疏MLA推理链路——具体通过FlashInfer HND KV Cache及其元数据到MATE FlashMLA布局的显式转换实现。针对模型创新性引入的iHC结构,团队基于MATE高性能算子库与 TileLang-MUSA,完成了iHC pre、post和head融合算子的迁移与调优,有效减少算子碎片和中间张量开销。
▼ 在推理性能层面,MTT S5000凭借硬件级原生FP8加速能力,在推理过程中使用DeepGEMM加速Dense层与MoE专家计算;同时针对MoE Router的小Batch GEMM场景,设计了BF16输入、FP32输出的专用融合算子,在提升推理性能的同时保障路由计算的数值稳定性。
▼ 在超长上下文支持方面,1M Tokens超长窗口对显存容量、访存带宽及KV Cache管理提出极高要求。MTT S5000凭借大显存、高带宽的硬件特性与vLLM-MUSA缓存管理体系深度协同,为1M级长序列提供充足的缓存空间与卓越的数据吞吐能力。
摩尔线程将继续依托MUSA软件栈强大的生态兼容性,保持对前沿大模型的快速适配能力,以高性能国产算力基础设施,为开发者提供稳定可靠的AI算力支撑。