摩尔线程联合国内头部新能源材料企业AI4S研发团队,基于自研MUSA统一系统架构与旗舰级AI训推一体智算卡MTT S5000,依托MUSA科学计算套件完成全球两大主流分子动力学模拟软件——GROMACS与LAMMPS的MUSA全栈迁移,完整打通了国产GPU面向该领域的软硬件协同能力,为新能源材料研发及计算化学仿真提供了自主可控的高性能计算底座。
摩尔线程同步完成了覆盖多尺度真实工业体系的基准测试,以及长时稳定性、精度、性能的对比验证,相关实测覆盖单卡吞吐、多卡扩展及跨硬件精度对标等全维度数据。结果表明,摩尔线程全功能GPU已具备工业级分子动力学科学计算的落地应用能力,在材料仿真场景中的性能表现超越国际主流GPU方案。
算力瓶颈与生态壁垒
制约分子动力学仿真效率
分子动力学(Molecular Dynamics,MD)仿真是新材料开发与生物分子相互作用研究的核心工具。GROMACS与LAMMPS作为两款主流开源软件,覆盖了生物医药蛋白体系、电解液、凝聚态材料等仿真场景,可完整支撑溶剂化建模、长程静电求解、平衡弛豫、轨迹分析等全研发流程。高精度仿真虽能显著缩减实体实验次数、降低新材料研发成本,但行业长期面临两大痛点:
• 算力瓶颈:大规模原子体系计算量庞大,CPU集群仿真周期可达数天甚至数周,拖慢研发迭代效率;
• 生态壁垒:海外GPU计算生态长期形成的技术路径依赖,使国产硬件普遍面临软件兼容性不足、多卡通信损耗偏高、长时仿真精度与稳定性欠缺等挑战。
本次摩尔线程的迁移与优化,正是针对上述难题,完成了应用层软件迁移、底层算子重构、工业场景实测与跨硬件精度校验的全流程落地。
GROMACS分子仿真
工业级生产稳定性
GROMACS是全球应用最广泛的开源分子动力学模拟软件之一,常年稳居科学计算领域高频使用前列,在生物医药蛋白模拟及溶剂分子仿真领域普及率极高。此前,该软件仅支持CPU与国际主流GPU后端。
摩尔线程已完成GROMACS 2023.3与2026.1双版本的MUSA迁移,将近程作用力、PME长程静电、键合作用及积分更新等全部核心计算步骤迁移至GPU执行,有效减少了CPU与GPU间的频繁数据传输损耗。同时,针对MTT S5000硬件架构,还开展了任务分片、内存排布与并行算子的深度调优。
核心优化亮点
▼ 重构MUSA专属算子,优化粒子随机访问与并行特征,降低显存读写延迟,充分释放摩尔线程全功能GPU的单卡算力;
▼ 实现全流程GPU驻留计算,规避CPU与GPU间频繁数据拷贝带来的性能损失;
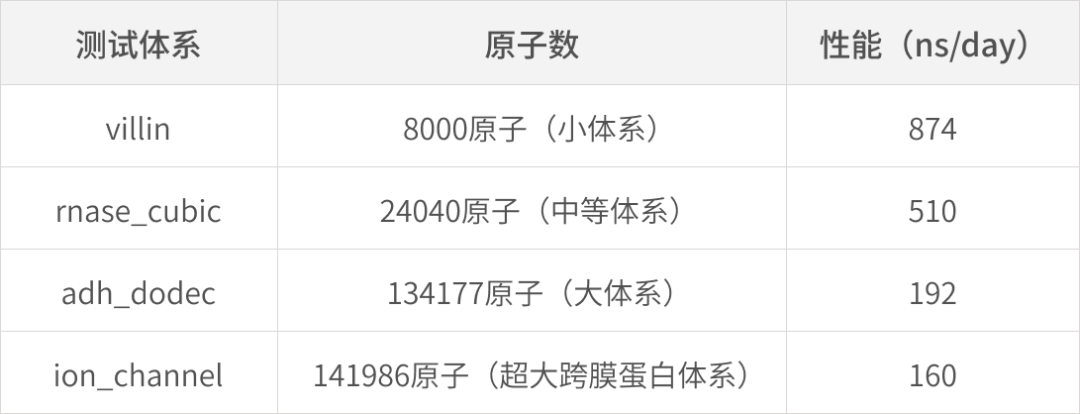
▼ 覆盖8千至14万原子四个标准蛋白溶剂化算例,经多轮重复测试,性能表现稳定,满足工业连续运行需求。
实测性能稳定
以ns/day(每日模拟纳秒时长)为性能指标,在四个标准蛋白体系MTT S5000单卡实测中,各体系经多轮重复测试,性能数据均无明显波动,MUSA版GROMACS单卡运行稳定,已具备直接投入批量仿真工作的能力。
*每体系测量三次,取中位数。
LAMMPS材料仿真
精度对齐 性能超越
LAMMPS是电解液、金属及凝聚态材料仿真的核心工具,广泛应用于动力电池研发等大规模材料仿真场景。针对工业电解液这类数十万原子级的典型大体系,摩尔线程已完成LAMMPS 2023与2025双版本的GPU后端移植,并基于工业级电解液算例开展精度与性能双重验证,全面检验计算效率、运行稳定性与仿真结果可靠性。
▼ 仿真精度对齐
实验统一设置2500万仿真步(5ns NPT平衡+20ns NVT弛豫)。在CPU、国际主流GPU、摩尔线程GPU三套平台上独立运行优化流程。摩尔线程GPU全程无报错、原子丢失或数值发散等异常,长时运行稳定性达标,仿真结果数值精度三方一致。
▼ 加速性能超越
以CPU方案为基准,摩尔线程GPU总耗时为37058秒,实现2.5倍全局加速;相较国际主流GPU,相同硬件配置下,总耗时降低31.8%。其中,NPT与NVT阶段加速比分别达到2.4倍和2.5倍,端到端仿真效率优势显著。
上述结果表明,在十万原子以上的工业电解液这类大规模材料仿真场景中,摩尔线程全功能GPU与国际主流GPU方案精度对齐,同时具备显著的加速优势,可有效支撑工业级研发需求。
MUSA科学计算套件
分子仿真一站式迁移工具链
摩尔线程自研的MUSA科学计算套件,集成了国产编译器、并行数学库及性能诊断调优工具,兼顾应用迁移便捷性与硬件算力高效利用。GROMACS、LAMMPS及流体仿真等工业软件均可基于MUSA完成国产化迁移,提升仿真效率,助力企业平滑完成技术栈替换。
容器化仿真落地典型场景
▼动力电池电解液微观机理仿真
依托MUSA科学计算套件,可高效完成工业级电解液模型的大规模分子动力学模拟,精准解析离子传导与界面副反应等微观机制,为电解液配方设计与性能优化提供可靠数据支撑。
▼千万步级超长时仿真
标准化容器环境已支持千万步级分子模拟任务稳定运行,热力学与微观结构曲线与国际主流GPU方案一致,验证了长时仿真在物理精度上的可靠性。
官方文档与资源
▼摩尔线程MUSA科学计算套件
https://docs.mthreads.com/scientific-computing-suite/version-1.1.0/release-note
▼摩尔线程MUSA科学计算套件容器镜像
国产算力加速科学计算
当前,AI4S(AI for Science)正加速融入生物医药、新能源材料等领域的科研与工业研发实践,其快速发展对底层算力与软件工具链提出了更高要求。摩尔线程全功能GPU及MUSA科学计算套件已具备支撑工业级分子动力学仿真任务的完整能力,验证了国产GPU在复杂科学计算场景中的可行性与工程成熟度,为关键领域的研发效率提升与算力自主可控提供了实质性路径。
摩尔线程将持续推进科学计算软件栈的迭代优化,拓展更多科研与工业应用场景,为国产科学计算生态的长期发展奠定坚实基础。
- 测试环境说明:
以上测试数据均来自摩尔线程实验室。具体测试平台采用8卡高性能计算节点,搭载摩尔线程MTT S5000智算卡,单卡配备大容量显存,可承载十万原子级超大分子体系;配套 MUSA 5.2.0软件栈与自研编译工具链mcc,原生支持FP64双精度、混合精度科学计算,可充分适配分子模拟中海量粒子的并行计算需求。整机配备128核CPU、2TB系统内存,操作系统为Ubuntu 22.04。测试素材统一使用行业通用标准算例及动力电池电解液工业仿真模型,测试结果符合真实产业研发场景。