随着端侧AI与自动化电脑控制技术的爆发,如何在有限的算力设备上部署高响应、长序列任务的智能体,成为行业的核心痛点。
近日,摩尔线程发布面向真实生产环境的端侧GUI智能体——LiteGUI。相较于先前的MT GUI Agent,LiteGUI实现了全面升级:它开创了基于OPD和RL的全新训练范式“无依赖SFT(SFT-Free)”,同时依托自研数据采集管线构造了高质量长序列任务数据。LiteGUI 仅凭2B参数量跨级超越了72B大模型的性能表现,在ScreenSpot-Pro、OS-World等多项基准测试中斩获 SOTA。其完整训练集与基准测试即将全面开源。
技术突破:无依赖SFT训练范式
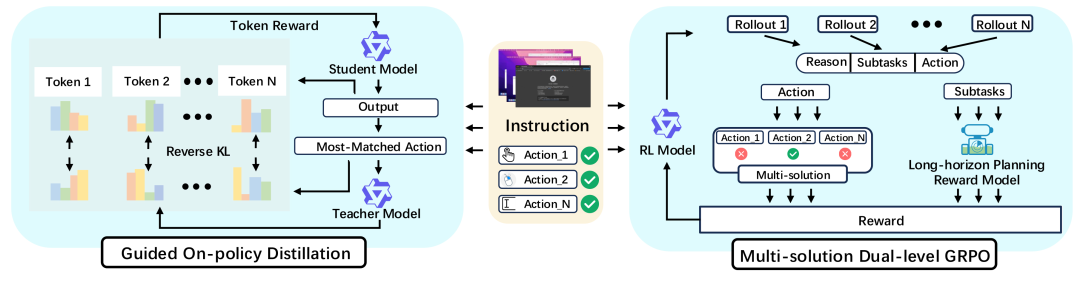
传统轻量化模型在控制图形用户界面(GUI)时,往往高度依赖监督微调(SFT),极易导致模型过拟合、灾难性遗忘以及策略僵化。LiteGUI 采用了“无依赖SFT(SFT-Free)”的全新训练范式,通过将大模型的通用知识无损“压缩蒸馏”至 2B-3B 级别的端侧小模型中,配合创新的强化学习机制,彻底解锁了轻量级智能体在复杂、长序列任务中的自主进化能力 。
该范式绕过了传统的监督微调阶段,依赖以下两项核心技术攻克了小模型在长序列任务中易“迷路”、易误判的行业顽疾:
▼业内首创“引导式在策略蒸馏(Guided-OPD)”:首次系统性将广义知识蒸馏引入GUI智能体领域。利用32B大模型作为“导师”进行实时在策略指导,并引入动态检索机制,契合GUI任务“殊途同归(多方案解决)”的本质,大幅降低轻量化模型的优化难度,减少AI幻觉。
▼多方案双层GRPO强化学习架构:针对传统强化学习因单一坐标匹配带来的“死板误判”问题,LiteGUI在宏观层面引入模型评估的子任务规划奖励,在微观层面引入多方案动作集动态匹配。即使用户控制路径发生偏移,智能体也能在执行过程中展现出极高的容错率与重规划能力。
两阶段的训练流程
性能表现:2B小模型斩获SOTA,超越72B行业标杆
在多项针对真实电脑环境、网页浏览器及文件系统的Live闭环测试中,LiteGUI展现出了领先行业的性能表现:
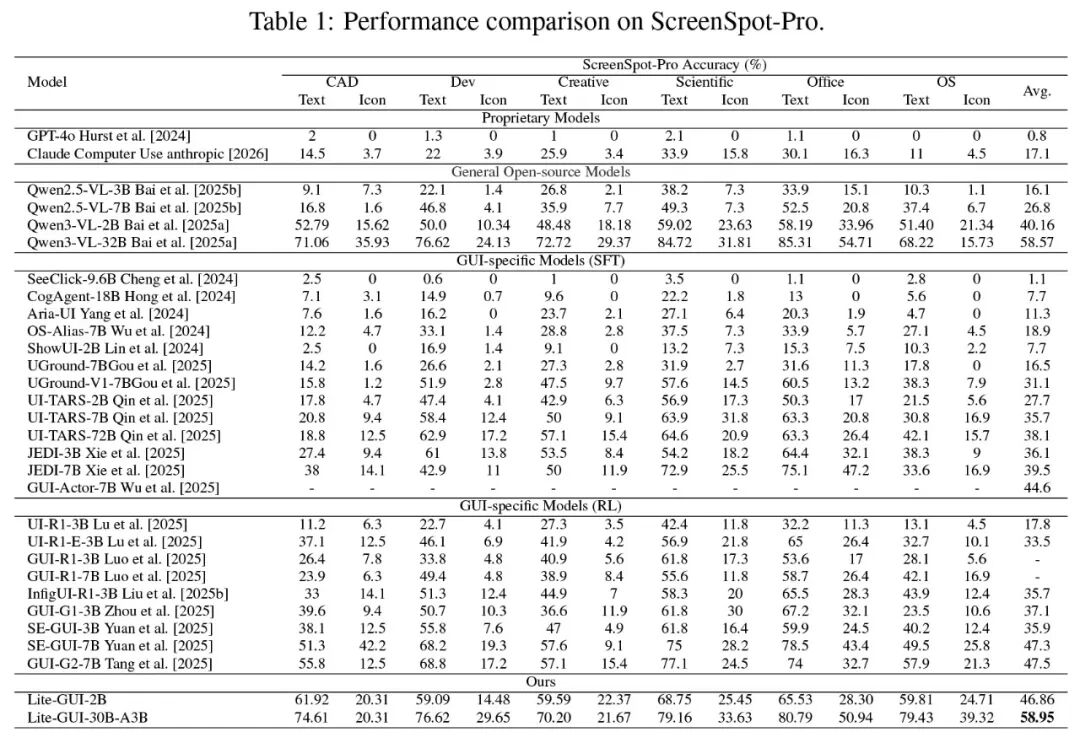
▼ScreenSpot-Pro权威基准:轻量版Lite-GUI-2B斩获46.86%的平均准确率,不仅刷新了同等参数量级模型的最高纪录(SOTA),更跨级超越了行业标杆模型UI-TARS-72B(38.1%)和JEDI-7B(39.5%)。
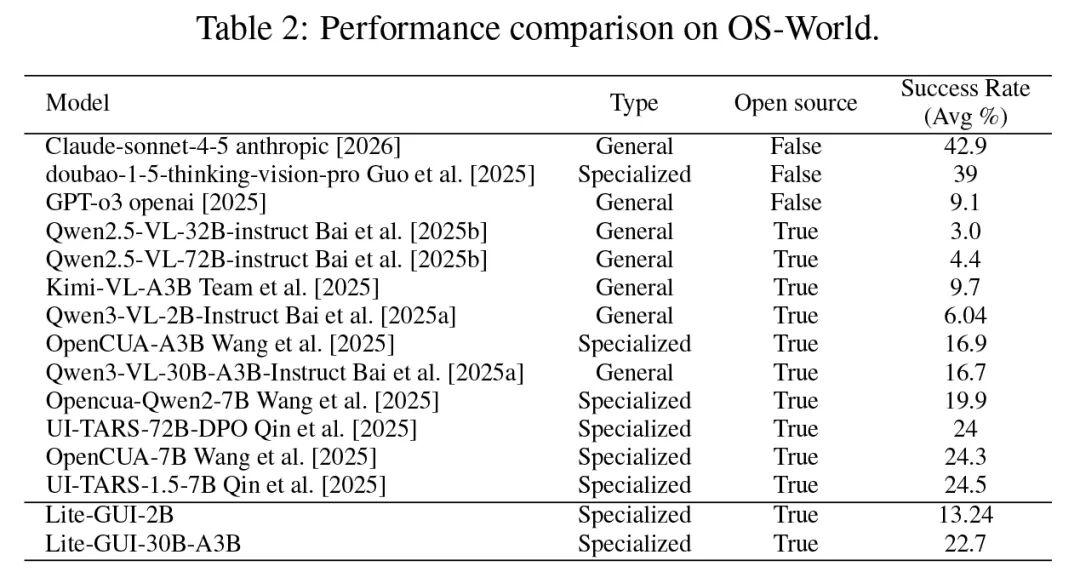
▼真实系统级控制(OS-World):Lite-GUI-2B的任务成功率达到13.24%,较原始基座模型Qwen3-VL-2B的6.04%,实现了2倍以上的性能提升;参数量更大的Lite-GUI-30B-A3B则达到22.7%,比肩更大规模的行业标杆专用模型。
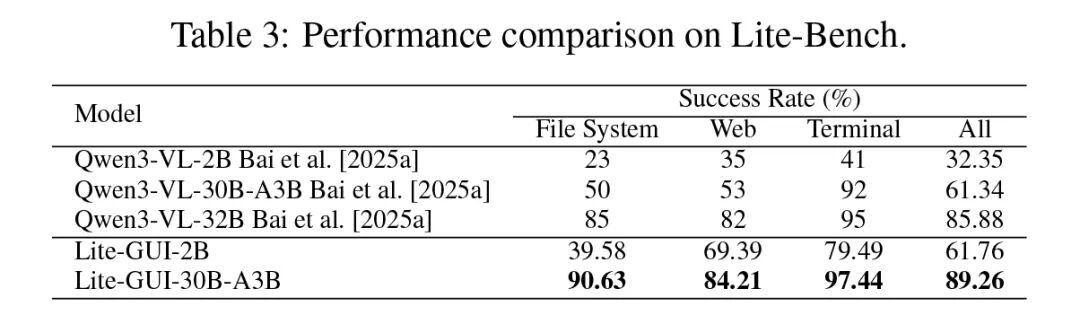
▼纯视觉无终端约束测试(Lite-Bench): 在完全禁止使用命令行、仅依赖视觉UI操作的严苛限制下,Lite-GUI-2B与Lite-GUI-30B-A3B分别取得了61.76%和89.26%的高分,远超基座模型。
开源生态:高质量数据集与开放评测基准
依托自动化轨迹生成与人工审核相结合的数据构建管线,摩尔线程AI团队将向全球开发者和开源社区开放高质量 GUI 数据资产,助力缓解端侧 GUI Agent 训练与评测中高质量长序列、多路径数据不足的问题 :
▼Lite-Dataset数据集:包含30000条多步GUI任务轨迹,其中包括11000条经人工验证的多方案(Multi-solution)动作标注样本。数据覆盖文件系统、终端命令、系统设置、WPS Office全套办公组件,以及VS Code、钉钉、数字人和AI助手等复杂交互场景,为Guided On-policy Distillation与Multi-solution Dual-level GRPO提供高质量训练信号。
▼Lite-Bench评测基准:包含160个Live动态闭环GUI测试任务,覆盖文件系统、Web浏览器和终端三大场景,其中包括75个Web任务、38个终端任务和47个文件系统任务。每个任务最多18步,用于系统评估GUI Agent在真实环境中的长程规划、视觉定位、复杂指令理解和错误恢复能力。
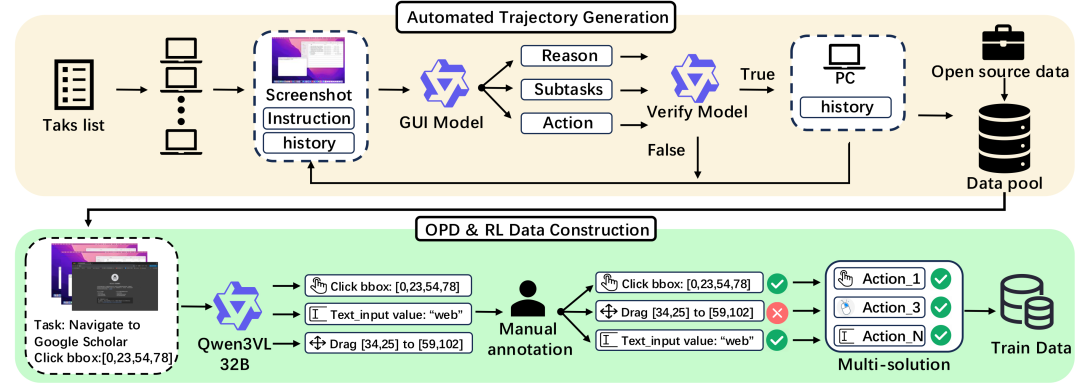
自动化数据采集管线和数据构造
目前,LiteGUI的学术论文已发表。核心训练代码、高质量数据集及评测基准即将在GitHub和Hugging Face开源,旨在推动全球端侧GUI智能体向更低能耗、更高普适性的方向演进。
查阅摩尔线程LiteGUI论文,请访问下方链接或点击“阅读原文”:
《LiteGUI: Distilling Compact GUI Agents with Reinforcement Learning》
https://arxiv.org/abs/2605.07505
- 以上测试数据均来自摩尔线程实验室。