2026年3月30日,摩尔线程宣布正式开源 MuJoCo Warp MUSA,为具身智能领域带来首个基于MUSA架构的全功能GPU加速物理仿真后端。该方案通过全链路并行加速与高效分布式扩展,在足式机器人运控训练任务中实现了相较CPU最高40倍的加速比。
长期以来,该领域的大规模强化学习仿真训练高度依赖单一国际算力架构,国产算力在底层生态支撑上存在空白。摩尔线程实现了国产全功能GPU在强化学习仿真训练领域零的突破。通过整合云侧大规模算力集群与自研端侧SoC芯片,公司构建起覆盖“训练到部署”的完整国产技术路径,为机器人仿真领域提供了首个全栈自主可控的算力参考标准。
物理仿真
具身智能进化的虚拟孵化器
机器人仿真技术,是指利用计算机软件,在机器人部署到实际物理生产作业环境之前,先在虚拟环境中通过物理引擎精确重现机器人及其工作场景的物理行为,包括重力、碰撞、摩擦、关节运动等机械动力学特性,并进行一系列充分的实验与试错,直至获得数学上稳定且鲁棒的最优解。随后,将这些经过严格验证、结果安全的机器人运动策略与配置参数,部署至真实物理机器人设备上进行生产作业,从而实现安全、高效的训练与验证过程,降低硬件实验风险,并提升整体系统可靠性。
这一仿真调试过程需要消耗极其庞大的计算量,涉及非线性方程组求解、碰撞检测、材料力学等复杂计算。为得到一组最优的机器人控制参数,通常还会采用强化学习框架,一次性同时运行数千个仿真世界。
由于这些计算高度并行化,CPU的串行架构难以满足实时与大规模迭代需求;而GPU凭借其数千个并行计算核心,可显著加速上述数值求解过程,从而支撑高效的迭代试错、海量参数优化以及实时仿真验证。
MuJoCo 物理引擎介绍
MuJoCo(Multi-Joint dynamics with Contact)是由神经科学家Emo Todorov开发、现由DeepMind维护的高精度物理引擎。它采用刚体动力学与接触模型,能够实时、稳定地模拟多关节机器人、摩擦力、碰撞反弹、肌肉与电机驱动等复杂物理交互,旨在推动机器人学、生物力学、图形与动画以及其他需要快速、精确仿真领域的研究与开发。自开源以来,MuJoCo迅速成为学术界与工业界应用最广泛的物理仿真平台之一,OpenAI Gym、dm_control等标准模拟平台均已集成MuJoCo作为其物理仿真后端。
早期开源的MuJoCo物理引擎基于CPU运行,在处理复杂接触场景或面向强化学习生成海量仿真样本时,存在显著的性能瓶颈。以一组经典的四足机器人运控训练任务为例,使用多核CPU的训练周期通常超过一个月。于是MuJoCo团队与国际主流GPU厂商合作,基于Warp编程语言开发了GPU加速版本的MuJoCo 物理引擎:MuJoCo Warp。
摩尔线程为物理引擎MuJoCo Warp增加了MUSA架构的原生支持,使MuJoCo物理引擎能够调用其全功能GPU,加速机器人物理仿真与强化学习训练任务。
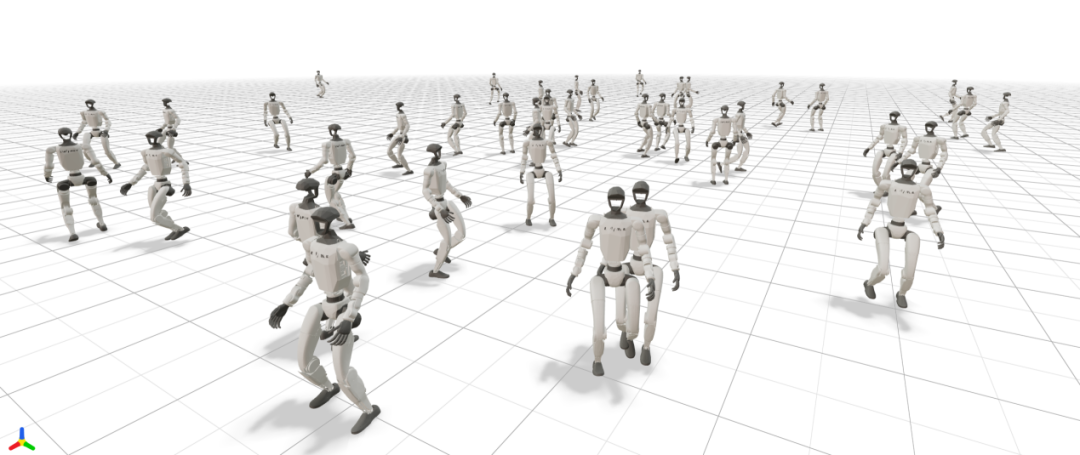
图注:MuJoCo Warp MUSA机器人仿真训练的阶段性过程Viser回放。
基础单元测试
在仿真精度与准确度方面,MuJoCo Warp MUSA与MuJoCo Warp CPU版本进行了严格的计算一致性对齐。实测显示,单个仿真步长(Step)的计算结果与CPU版本的绝对误差控制在1e-5以内(qpos关节位置差异),通过MuJoCo自带Viewer进行可视化验证,对比结果如下。
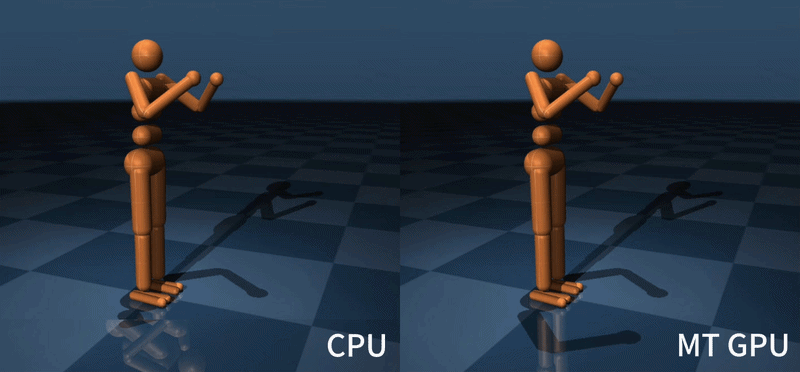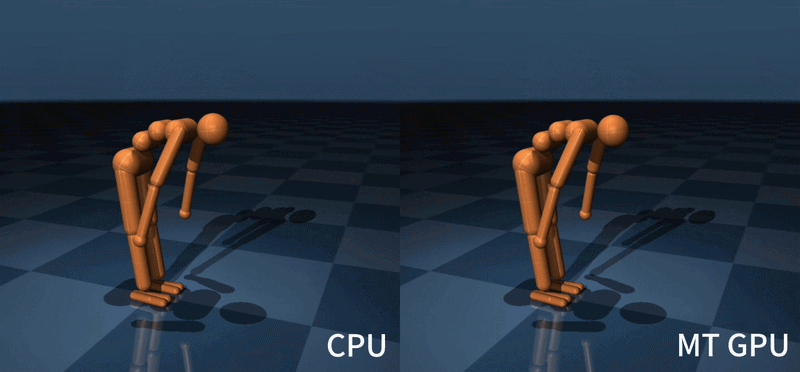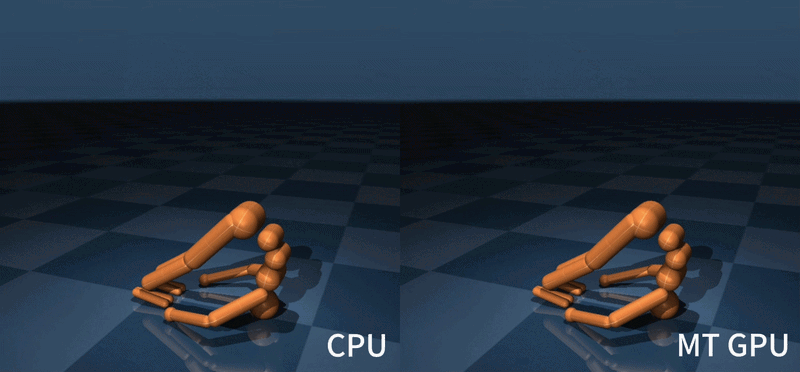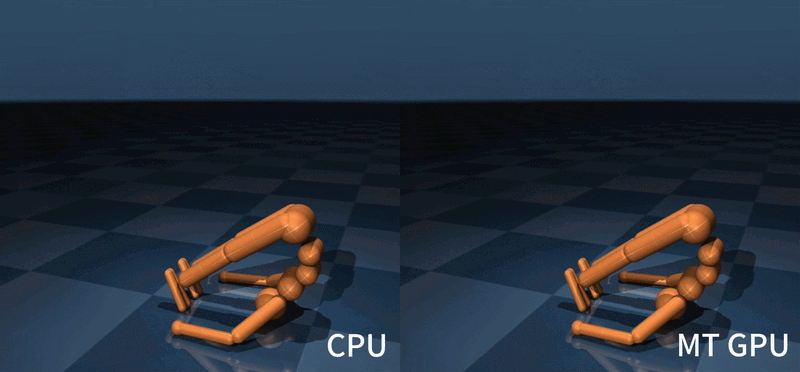
视频:Humanoid GPU-CPU 对比测试,配置参数如下。
nbody: 17
solver: NEWTON
iterations: 10
integrator: EULER
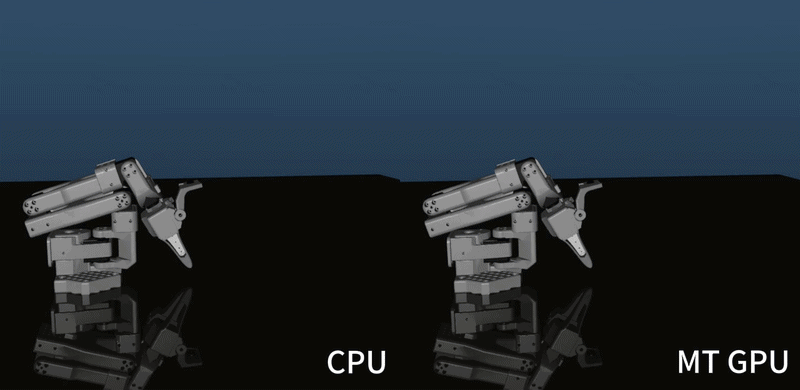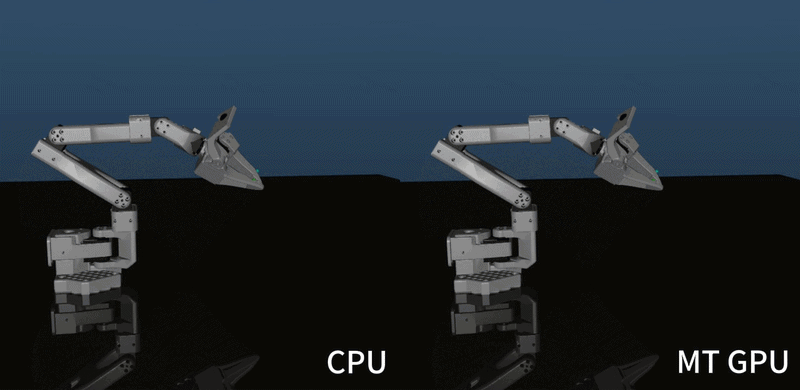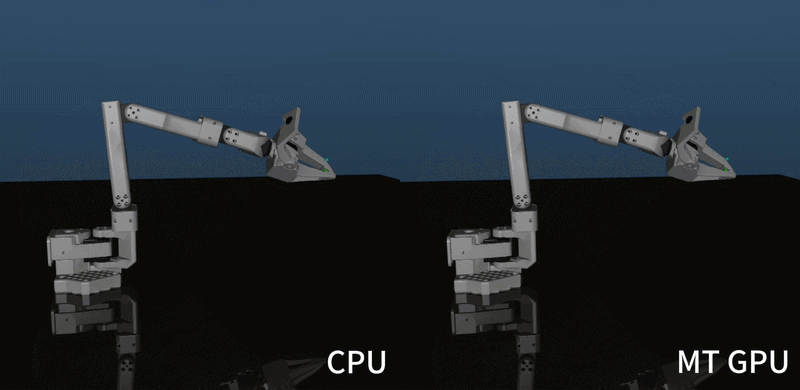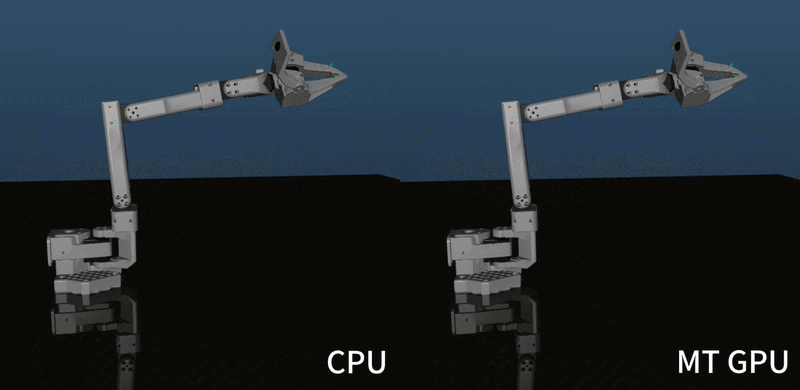
视频:LeRobot GPU-CPU 对比测试,配置参数如下。
nbody: 10
solver: NEWTON
iterations: 10
integrator: EULER
完整机器人训练测试
在单个机器人的物理仿真结果通过单元测试后,我们使用 MuJoCo Warp MUSA 物理引擎进行一系列完整的强化学习训练任务测试,以证明使用摩尔线程全功能GPU加速的MuJoCo物理引擎,可以稳定地用于强化学习运控训练任务加速。
我们根据训练难度由低到高,先对四足机器狗的运控进行训练,然后进行两足人形机器人的模仿学习训练。
四足机器狗运控训练:40倍加速比,1小时收敛
我们采用宇树Go2机器狗进行平地环境运控训练,不添加视觉传感器与额外控制信息,使用摩尔线程旗舰级训推一体全功能智算卡MTT S5000,单卡1小时即可完成训练收敛目标, 并可保持2小时持续稳定运行。
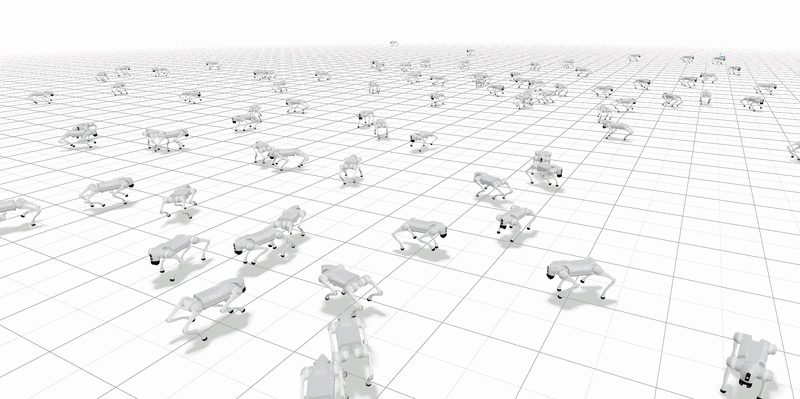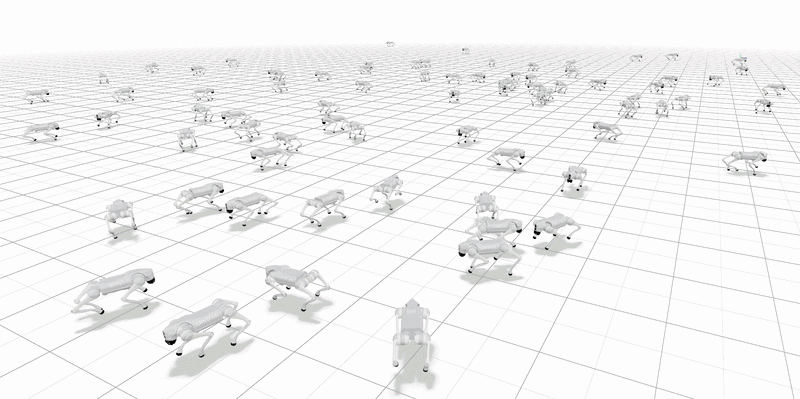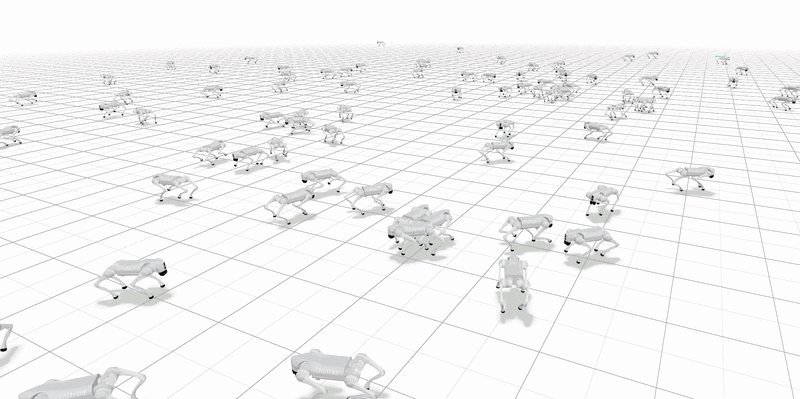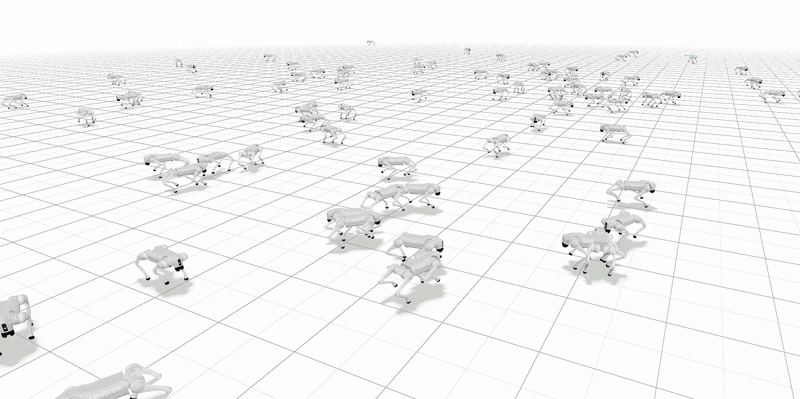
视频:在Viser中回放Go2机器狗运控训练结果(第500次迭代)。
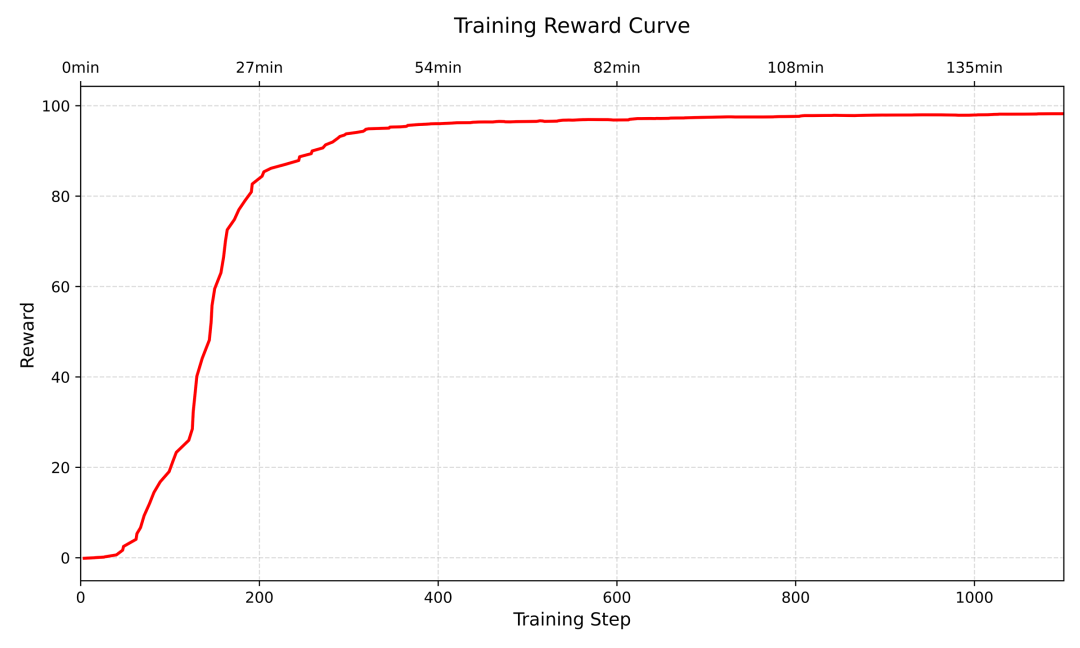
图注:Go2机器狗平地环境运控,关键训练配置参数如下。
num environment: 4096
solver: newton with PCG 10 iterations
ccd_iterations: 50
num_steps_per_env: 24
decimation: 4
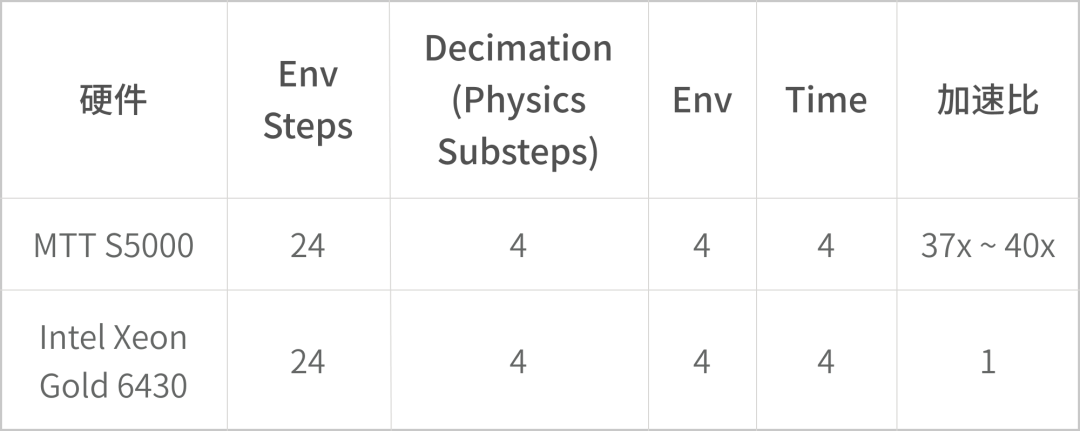
MuJoCo Warp MUSA实现了从物理数值求解到环境并行管理的全链路加速。如下实测数据显示,在典型的四足机器人训练任务中,MTT S5000单卡处理4096个仿真环境仅需7~8秒,而对比组的多核CPU则需280~300秒,实现约40倍的加速比,显著提升了训练效率。得益于此,原本需耗时数周的训练任务可在1小时内完成收敛,大幅缩短了训练周期。
两足人形机器人模仿学习训练:单卡4.8天完成训练
在更高难度的两足人形机器人训练任务中,MuJoCo Warp MUSA同样表现稳定。
针对宇树G1人形机器人的模仿学习任务,系统以动作捕捉(Motion Capture)数据为目标轨迹,让机器人通过强化学习使自身关节位置、速度及姿态最大程度跟踪参考运动,并在奖励函数中引入姿态误差、速度匹配及能量惩罚项,实现从动补数据到机器人本体的自然动作迁移。
如下视频所示,训练过程中,策略以目标动作轨迹作为参考输入(左),通过对机器人各关节的连续控制,学习在物理仿真环境中稳定完成整套动作,同时保持身体平衡与动态稳定。经过训练后,策略能够在仿真环境中较为准确地复现参考动作(右)。
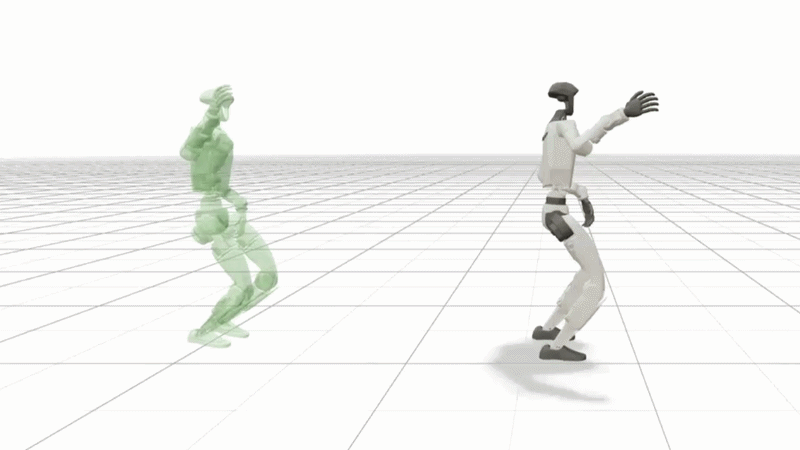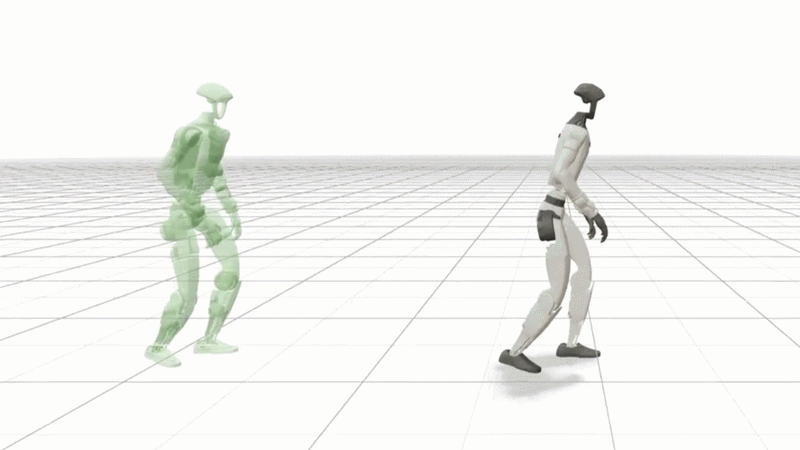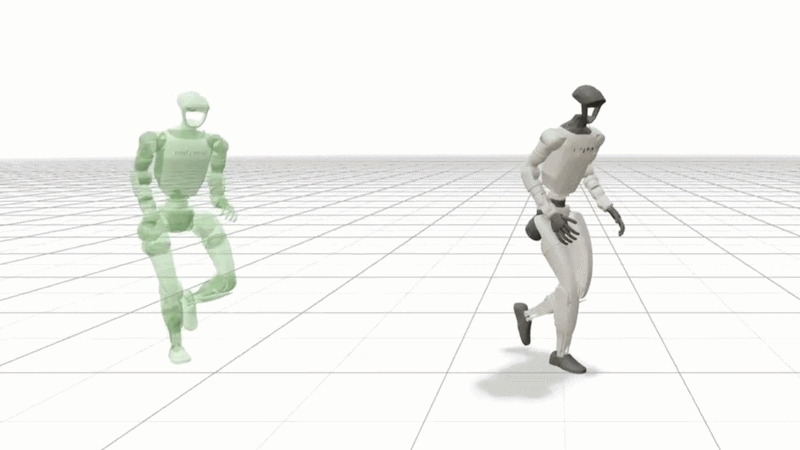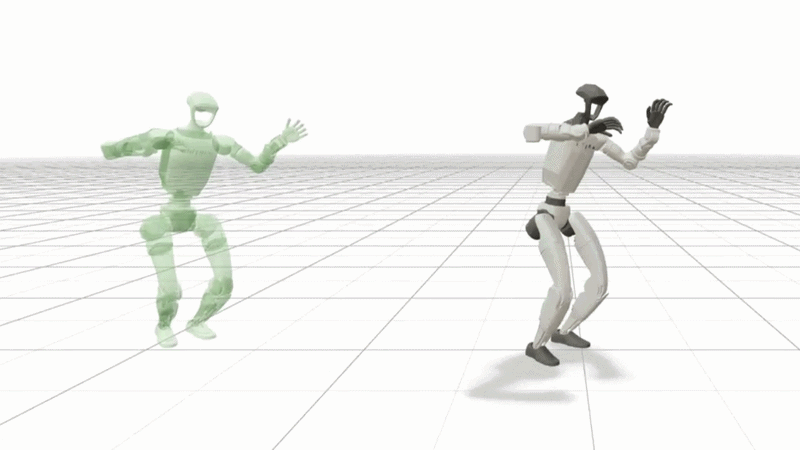
视频:G1人形机器人动作跟踪(Motion Tracking)训练实验。
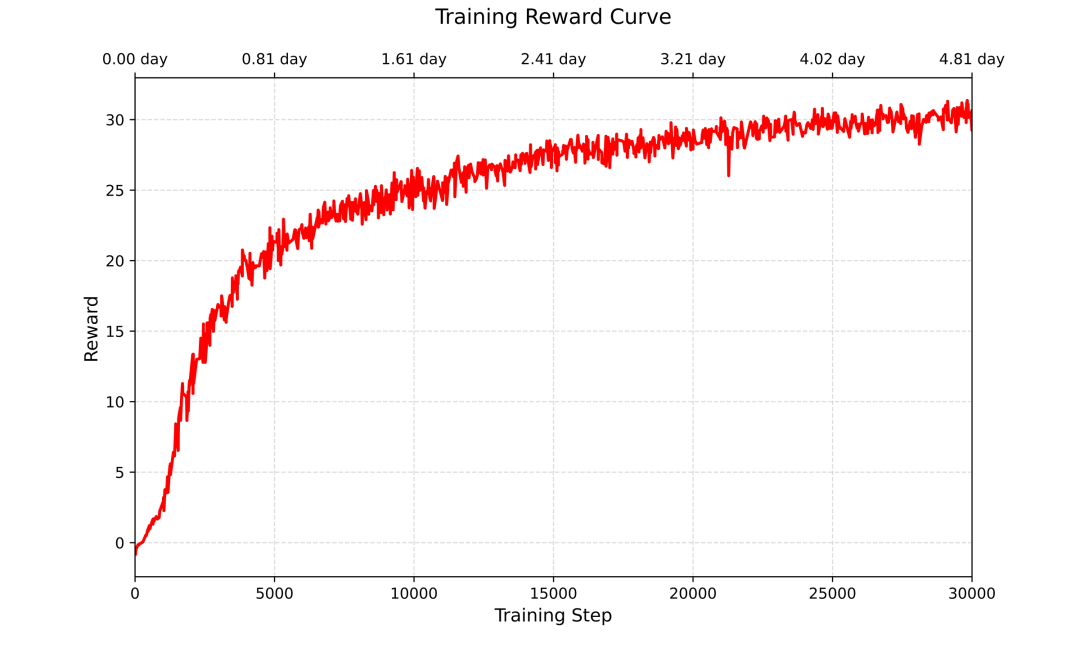
如下图实测数据显示,G1两足人形机器人动作跟踪训练,MTT S5000单卡训练约4.8天即可完成收敛。
分布式GPU加速测试:32卡线性加速 最快 3.6 小时完成训练
面对两足人形机器人这一类复杂训练任务,单GPU往往难以满足复杂训练任务的计算需求,需要用到多块GPU进行分布式训练加速。据实测数据显示,收敛速度随GPU数量增加呈近线性提升,单次迭代耗时基本不变。这意味着原本需数周的复杂训练任务,如今可在数天内高效完成,大幅提升算法迭代效率。验证了MuJoCo Warp MUSA在分布式训练上的可靠性。
如下图所示,G1人形机器人动作跟踪训练,MTT S5000单卡与8卡训练结果对比,8卡训练收敛加速达8倍以上。
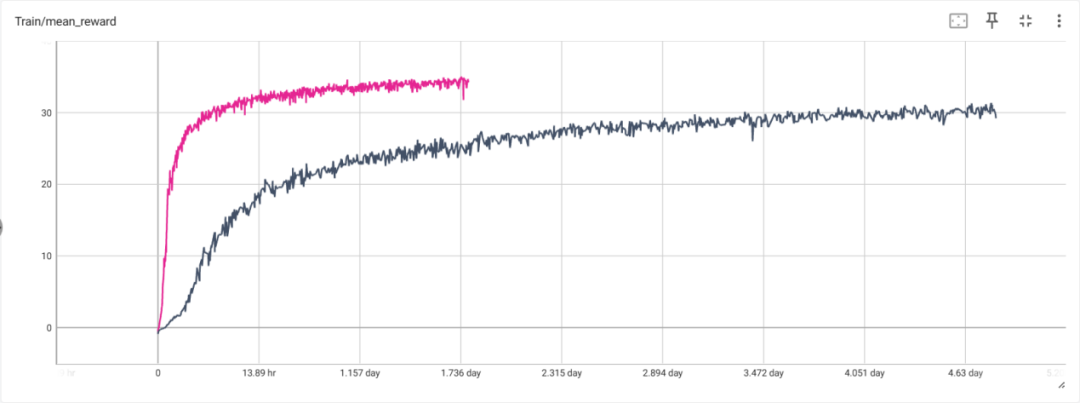
图注:G1人形机器人动作跟踪训练,MTT S5000单卡与8卡训练结果对比。
如下表所示,我们采用数据并行(Data Parallelism)策略:每张GPU运行4096个env环境,一共同时计算8×4096 = 32,768个env,进行分布式并行仿真,收敛速度随GPU数量增加接近线性提升,而单次迭代耗时基本不变。
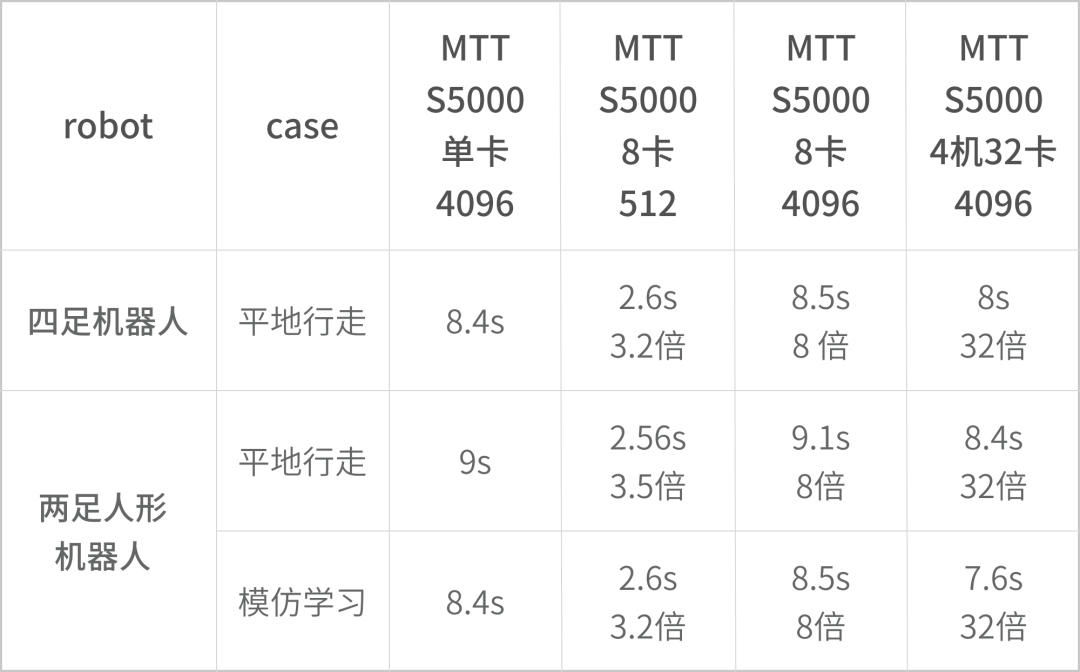
图注:分布式加速性能。表中“时间”为单步仿真耗时,“倍数”为训练收敛加速比。
Sim2Real 真机验证
Sim2Real是将强化学习策略从仿真环境迁移至真实机器人的关键技术,旨在解决仿真与现实世界之间的差距问题,包括物理参数不匹配、传感器噪声及动态差异等。为验证MuJoCo Warp MUSA训练生成的策略在真实物理世界中的有效性,我们对所有训练结果都进行了完整的Sim2Real测试,通过将训练策略直接植入真实机体,对MuJoCo Warp MUSA的仿真有效性进行了系统化的验证。
四足机器狗Sim2Real 验证
经过强化学习训练,Go2机器狗最终部署的运动控制策略被精简为一个仅含45个参数的轻量化神经网络。神经网络输入为Go2 机器狗本体携带的各种传感器的输出信息(1个惯性测量单元 IMU,12 个关节状态传感器),神经网络的输出为执行器电机扭矩强度指令τ (单位为 N·m),最终控制机器狗本体的位姿状态。
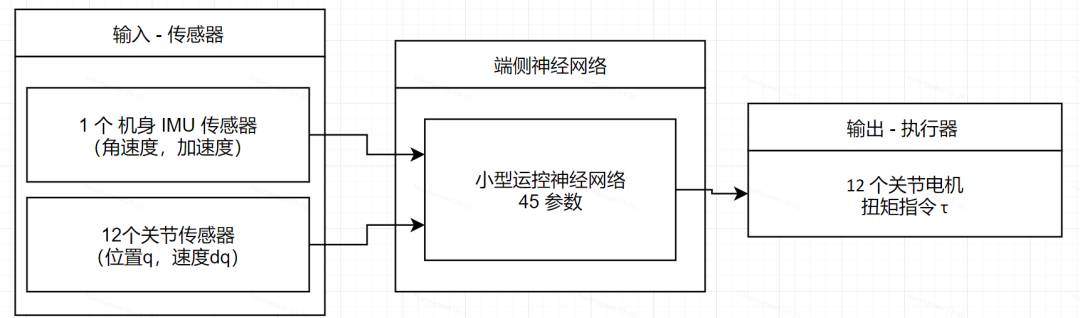
部署阶段,神经网络与机器人本体通过DDS(Data Distribution Service)协议进行双向数据传输。DDS协议采用发布-订阅(publish-subscribe)架构,确保传感器数据与神经网络控制指令在毫秒级周期内完成信息同步交换。
两足人形机器人Sim2Real 验证
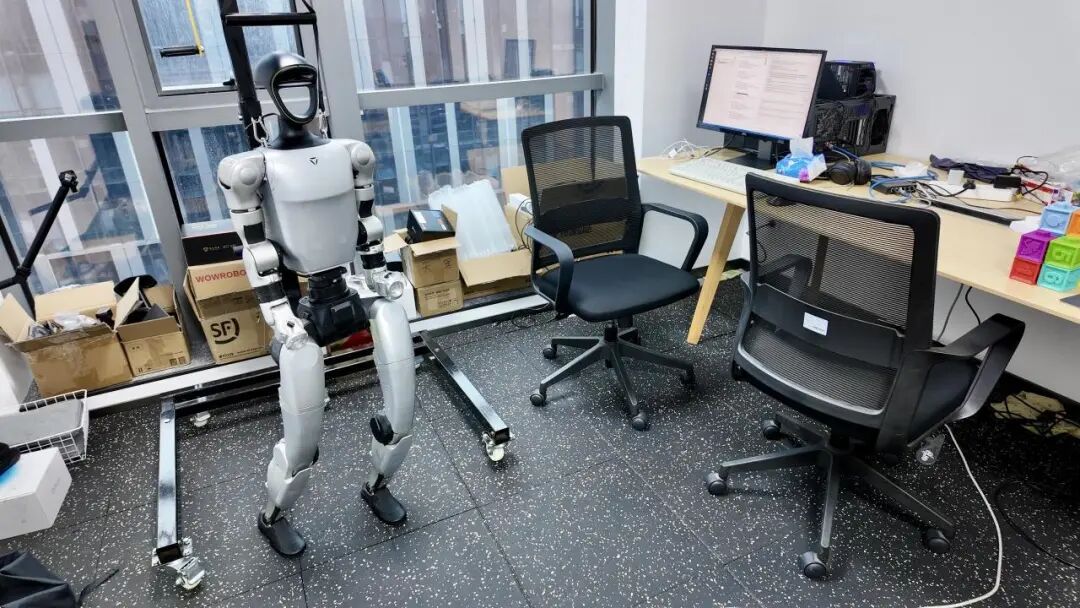
在G1人形机器人的真机验证中,机器人能够高精度跟踪复杂的舞蹈动作轨迹,整体运动过程稳定、连贯,并展现出良好的动态平衡能力。这进一步验证了 MuJoCo Warp MUSA 生成的策略在真实物理世界中具有高度的鲁棒性。
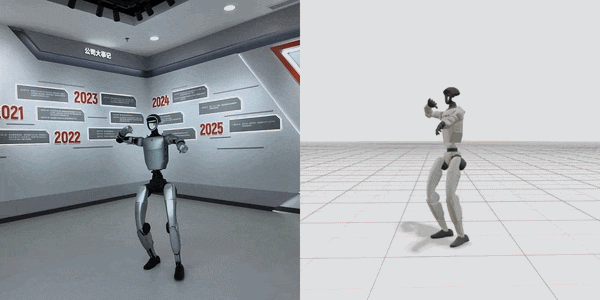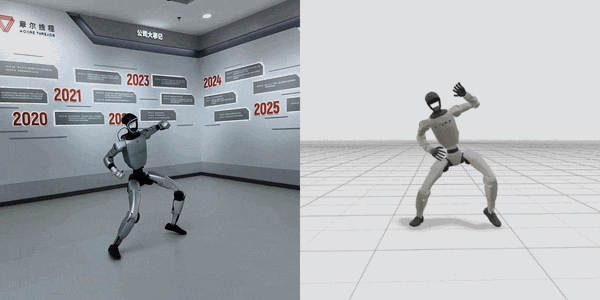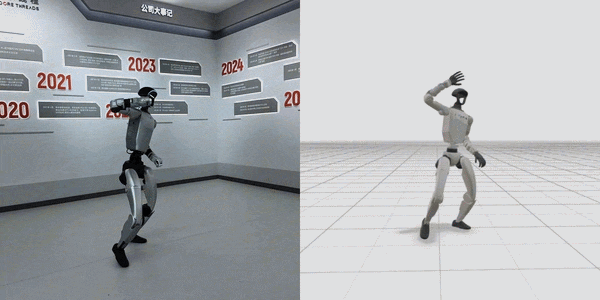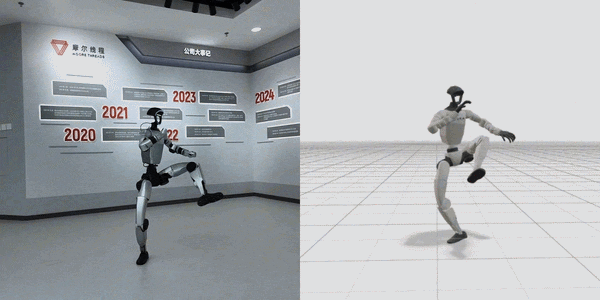
视频:两足人形机器人真机验证,高精度跟踪舞蹈动作轨迹。
自研SoC芯片协同:赋能终端应用加速
摩尔线程提供了从仿真训练到真机部署的完整闭环支持。在真机部署阶段,机器人本体采用了摩尔线程自研的长江SoC芯片作为端侧控制核心。该芯片算力不仅能满足基础运控策略的需求,同时可支持语音TTS、ASR、各类CV模型以及端侧大模型的部署。这种“云侧大规模加速、端侧高效能执行”的端云协同架构,为具身智能终端提供了全方位的算力支持。
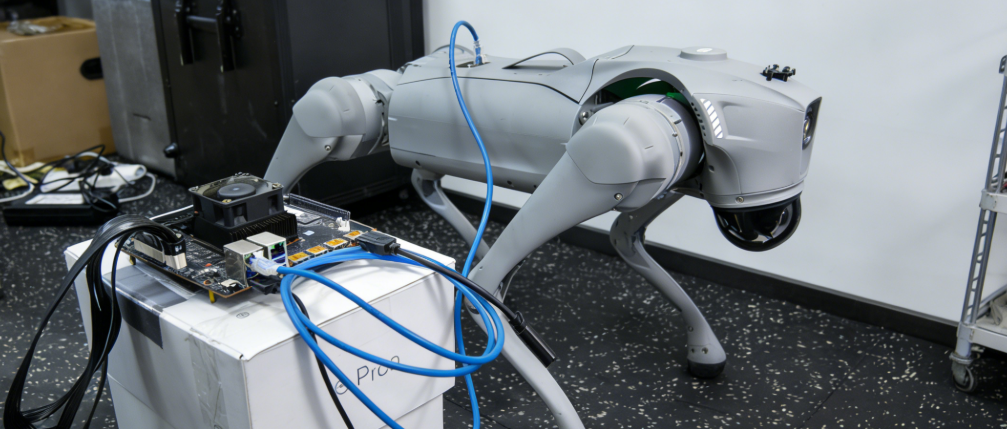
图注:正在进行策略部署调试中的机器狗,端侧控制采用摩尔线程长江SoC芯片。
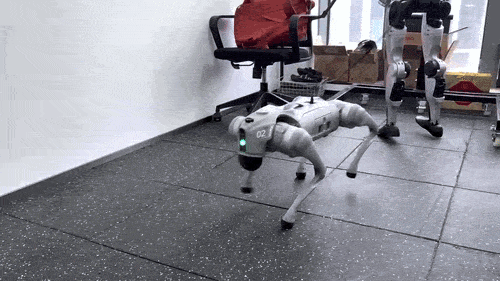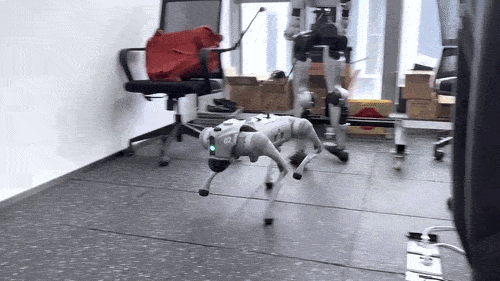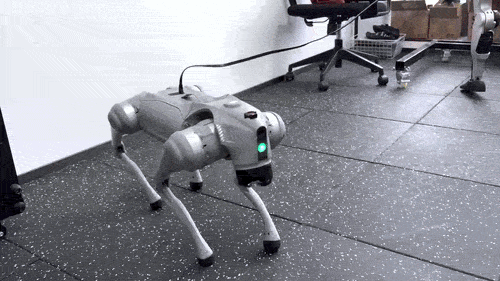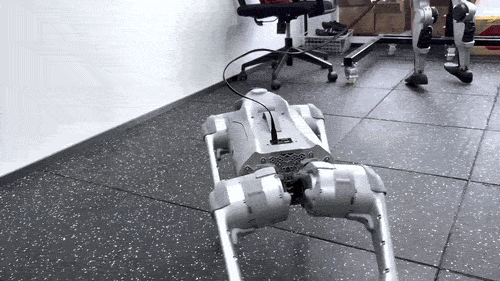
视频:使用摩尔线程长江SoC芯片对机器狗进行端侧控制的真机运行效果。
开发者体验:云端试用
开发者可依托摩尔线程MTT KUAE智算集群的MTT S5000智算卡资源,在高性能算力与安全合规的云端环境下快速开启大规模仿真任务。
目前,MTT KUAE平台已面向开发者开放试用申请。
▼申请通道:
https://metapark.mthreads.com/kuaetry
开源共建:共创国产具身智能未来
MuJoCo Warp MUSA的开源,不仅是摩尔线程在机器人仿真领域的一次技术突破,更是构建全栈国产具身智能生态的关键里程碑。通过提供自主可控的物理仿真加速方案,摩尔线程为国内开发者与科研机构夯实了从算法研发到真机部署的国产技术底座,助力降低对海外仿真平台的依赖,加速机器人从虚拟实验室走向复杂现实环境的进程。
摩尔线程将持续优化MUSA软件栈,并计划将当前工作整合重构为通用的机器人仿真训练平台——Lambda Lab,面向广大具身智能开发者定向开源,共同加速具身智能领域的技术创新。
我们诚邀全球开发者共同参与MuJoCo Warp MUSA的开源共建。无论是代码贡献、文档完善、问题反馈,还是创新性的技术构想,我们都期待您的参与。让我们携手在开源社区中,共同打造自主可控、坚实可靠的国产具身智能基础设施。
了解更多摩尔线程MuJoCo Warp MUSA的相关信息,请点击下方“阅读原文”或访问:
▼摩尔线程GitHub官方仓库:
https://github.com/MooreThreads/mujoco_warp_musa
*以上测试数据、视频及图片均来源于摩尔线程具身智能实验室。