近日,随着阿里巴巴通义千问开源Qwen3.5系列小尺寸模型,摩尔线程率先完成对该系列模型的极速适配。基于自主研发的智能SoC芯片“长江”,摩尔线程在模型发布当天即成功实现Qwen3.5-9B的推理部署与验证,并通过vLLM-MUSA推理框架完成端到端推理服务。这标志着国产端侧算力底座对前沿大模型的敏捷响应能力再上新台阶。
本次开源的Qwen3.5小尺寸模型包括0.8B、2B、4B和9B四款。这一系列模型继承了 Qwen3.5家族的强大基因,采用原生多模态训练、最新的模型架构,表现出卓越的性能,以满足从极端资源受限到高性能轻量级应用的不同需求。据官方评测,Qwen3.5-9B在多项基准测试中表现卓越,以三分之一的参数量,性能超越上一代的Qwen3-30B模型,并在视觉理解任务中展现出领先优势。
端侧算力底座,高效部署验证
摩尔线程自主研发的智能SoC芯片“长江”采用多核异构计算单元架构,提供高达50 TOPS的INT8算力,并全面支持FP16、FP32与FP64等多种精度混合计算,能够高效满足端侧大语言模型、图像识别、视频编解码、科学计算等多样化应用需求。
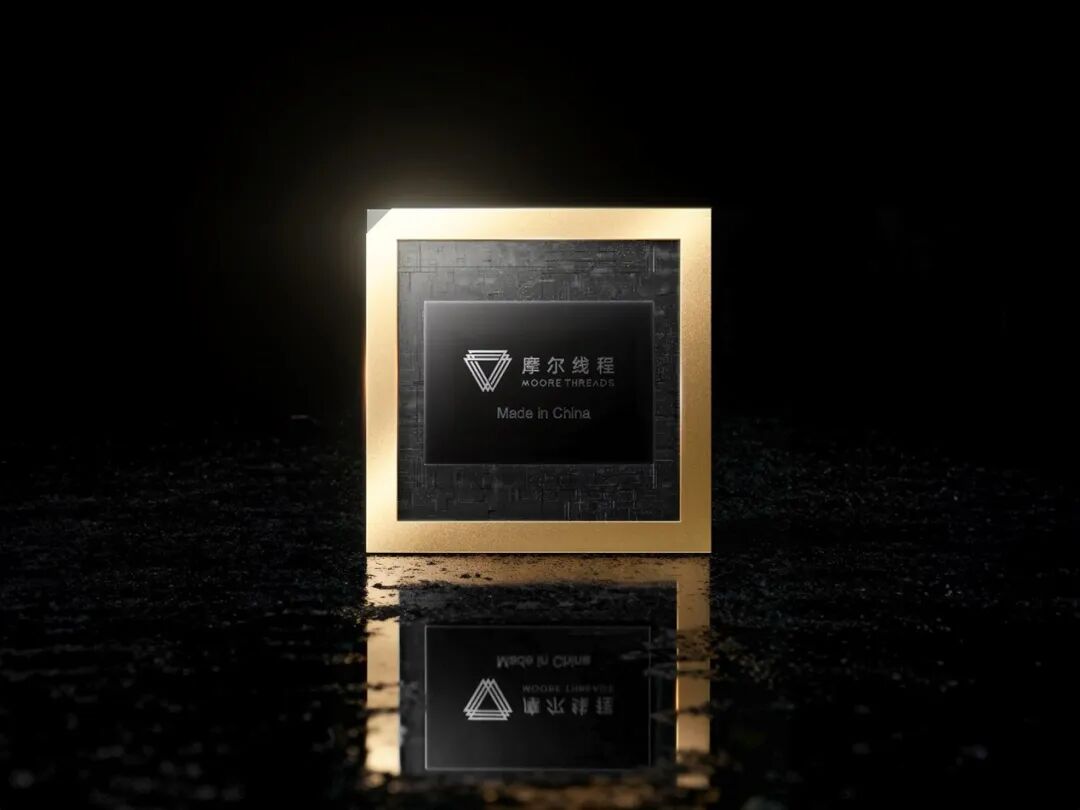
该芯片采用统一内存架构设计,支持带宽超过100GB/s的LPDDR5/LPDDR5X高速内存,最高可配备64GB容量,大幅提升高吞吐量与高并发任务的执行效率,满足边缘和端侧场景对实时数据处理和低延迟决策的严苛要求。同时,长江SoC在架构层面进行了能效优化,在保证强劲性能的基础上实现出色能效比,确保终端设备长时间稳定运行并有效控制能耗。
长江SoC的主要特性包括:
- 全大核CPU:主频最高可达2.65GHz,多核设计兼顾高性能与低功耗;
- 全功能GPU:支持高性能3D渲染,并加速AI计算与科学计算任务;
- 高能效NPU:采用双核可编程架构,可高效加速语音、图像等多模态模型推理;
- 视频VPU:支持8K@30fps的视频编解码,兼容H.265、H.264和AV1格式;
- 显示DPU:支持高清多屏异显,可实现2路8K@60Hz或8路4K@60Hz输出;
- 音频DSP:高性能双核设计,支持AI降噪与Hi-Fi级音效处理;
- 影像ISP:支持3200万像素图像处理及多路摄像头接入。
基于“长江”SoC与vLLM-MUSA推理框架,摩尔线程成功部署了Qwen3.5-9B的OpenAI兼容API服务,并完成了全面的模型功能验证。测试结果表明:
- 中文推理:成功完成红黑树实现、快速排序等复杂编程任务,输出完整且逻辑正确;
- 英文推理:准确解释梯度下降与反向传播算法,包含数学公式与代码示例;
- 多轮对话:上下文记忆完整,对话连贯自然;
- 长文本生成:600+ tokens输出质量稳定,无内容退化或乱码;
- Thinking模式:支持模型自主思维链推理后输出结构化答案。
MUSA生态优势凸显,算子级优化打通适配链路
本次Qwen3.5小尺寸模型的快速适配,再次验证了摩尔线程MUSA生态的核心能力:
原生MUSA C支持:开发者可直接使用MUSA C进行内核开发,大幅降低CUDA生态迁移门槛。本次适配中,fused_moe_gemv等关键算子通过MUSA C实现了高效的矩阵向量乘加速。
深度兼容Triton-MUSA:开发者可使用熟悉的Triton语法编写高性能算子,并通过Triton-MUSA后端无缝运行。Qwen3.5的fused_recurrent_gated_delta_rule、fused_gdn_gating等核心算子均通过Triton-MUSA成功运行。
vLLM-MUSA推理框架:完善的框架封装使新模型架构的适配周期大幅缩短。通过MUSA平台配置钩子机制,框架可自动适配混合注意力模型的KV Cache布局和注意力后端选择。
从GLM-5、MiniMax M2.5、Kimi K2.5到Qwen3.5系列,摩尔线程持续保持对国产顶尖大模型的Day-0级快速适配能力。这一敏捷响应机制,不仅源于MUSA架构对主流AI生态的无缝兼容与持续优化的工具链支持,更标志着国产算力底座已具备从模型适配到高效部署的全链路支撑能力。
Qwen3.5所采用的Gated DeltaNet混合注意力架构代表了端侧大模型的新范式——以线性注意力的恒定内存复杂度突破“内存墙”限制,在参数量大幅缩小的同时实现跨代性能超越。摩尔线程将持续深化对该架构的原生优化,基于muDNN计算库和Triton为混合注意力机制中的长序列处理提供更高效的算力支撑,进一步释放“长江”SoC在端侧与边缘推理场景的算力潜能。
*以上测试数据均来自摩尔线程实验室。