摩尔线程正式开源GPU计算驱动基准测试套件(GPU Compute Driver Bench),该工具以系统化、专业化的方式评估驱动性能,帮助开发者、研究人员、系统架构师和系统集成商,在各类计算与内存密集型场景下深入分析GPU驱动表现。
该套件支持跨平台使用,已在GitHub上基于Apache 2.0协议开源发布。它不仅适配摩尔线程全功能GPU的MUSA驱动,也兼容CUDA驱动,可以在跨平台、跨架构的测试中提供一致的性能评估基础。
GPU Compute Driver Bench从实际开发和部署角度出发,为行业提供了科学、系统的驱动性能衡量标准,有利于推动全球GPU生态的技术进步。
GPU驱动层隐性的“性能瓶颈”:
缺乏量化工具
在GPU计算领域,硬件规格与上层算子的性能常被广泛讨论,而连接二者的驱动层却长期缺乏系统化的评估工具。作为连接上层应用与底层GPU硬件的关键软件层,GPU驱动承担着内核调度、内存管理、资源分配、多流并行、跨设备通信等核心工作。无论是AI训练推理、科学计算,还是图形与多媒体应用,几乎所有GPU计算任务都必须经由驱动层释放硬件的潜力。然而长期以来,GPU性能评估主要聚焦于硬件规格或上层计算库(如算子、框架)的性能,而驱动层本身缺乏标准化的评估工具,这在一定程度上影响了GPU相关应用的发展。
GPU驱动不仅决定了功能是否可用,更在很大程度上决定了GPU性能的实际释放效率。尤其是在真实运行环境中,驱动层在执行应用调度、内存管理和资源协调时,会引入不可避免的额外开销,形成隐性的“性能税”。例如,小kernel频繁启动时的调度开销可能成为瓶颈、多流并发和同步效率受驱动实现制约、内存操作路径设计影响端到端性能、多GPU 通信和资源管理效率高度依赖驱动能力等。
举例来说,即使某款GPU的理论计算与带宽指标都非常出色,但在实际任务中性能表现却可能不及预期。由于缺乏针对驱动层的可量化评估手段,开发者在进行性能优化时,很难明确区分瓶颈究竟来自硬件、运行时、驱动层还是上层应用,从而导致性能问题难以定位和改善。这也正是建立GPU驱动层量化基准测试体系的根本原因之一。
GPU Compute Driver Bench:
为驱动性能量化而生
GPU Compute Driver Bench基于专为微秒级性能分析设计的C++测试框架Celero构建,不仅原生支持摩尔线程全功能GPU的MUSA架构,同时兼容CUDA及其它架构,提供MUSA/CUDA等多编译后端支持。用户可通过install.sh脚本完成统一安装与部署,并使用一键式CUDA↔MUSA代码转换工具musify,轻松实现不同GPU架构间的直接性能对比。
整个测试套件包含30多个专业子项,采用模块化设计,支持开发者根据实际需求灵活扩展测试场景,确保了工具的持续演进能力。
该套件精准聚焦GPU计算中最易出现驱动性能瓶颈的五大核心领域:
任务调度(Schedule):全面评估内核调度性能,涵盖内核执行时长、依赖解析效率、多流同步开销、模块加载效率及Graph模式对小kernel启动的性能提升效果。
多流并行(Stream):针对多流并发场景专项测试流间事件同步效率、内核执行并发性分析与依赖关系调度性能,量化驱动在并行任务协调与资源利用方面的能力。
内存操作(Memory):覆盖显存全生命周期性能评估,包括1B-4GB内存申请/释放效率、内存复用、多维拷贝带宽、主机设备通信性能,以及跨进程内存操作能力。
多GPU通信(Multicards):测量对等访问带宽与延迟,测试跨设备显存操作性能,并支持复杂多卡并行计算场景的模拟与评估。
资源管理(Resource):量化Event与Stream资源的创建、销毁及管理性能,评估高并发场景下的资源调度能力。
*以上为测试示例,数据来自摩尔线程实验室
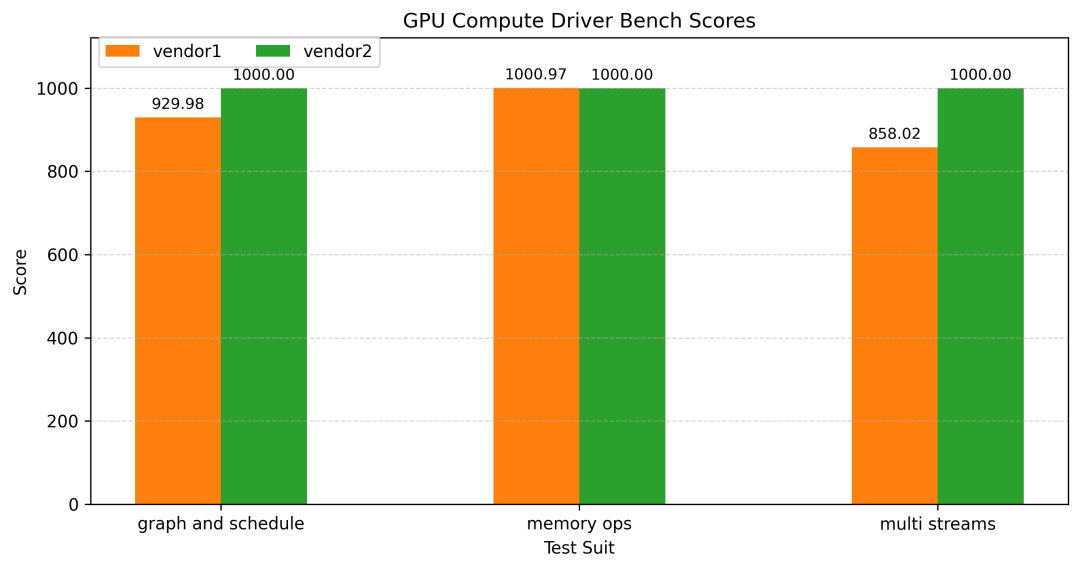
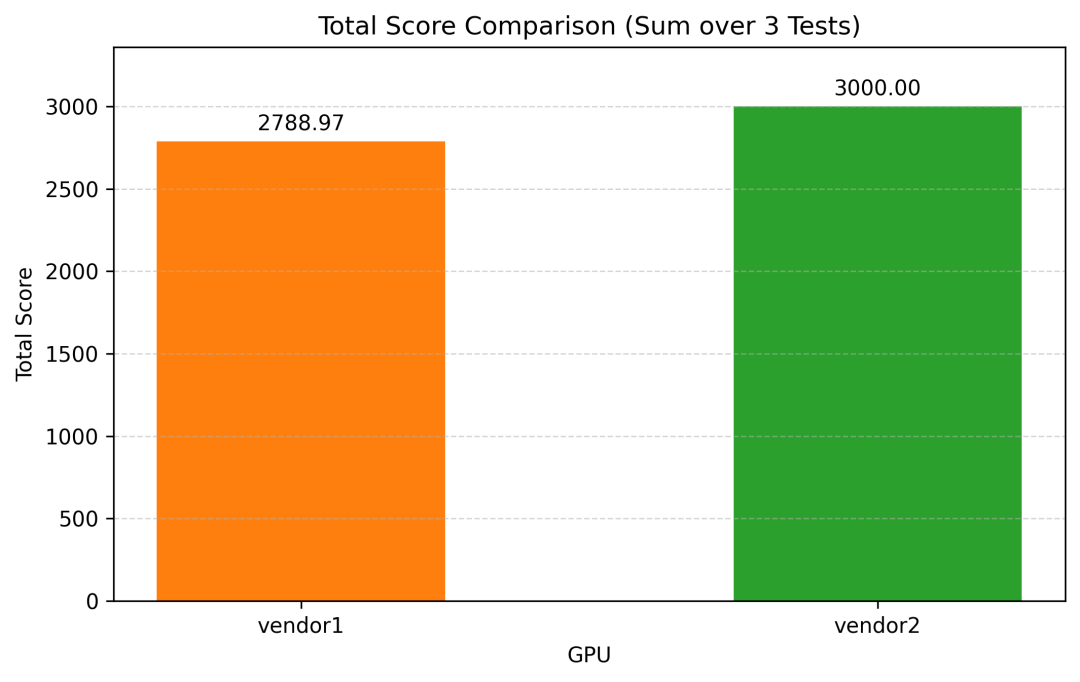
在测试成绩评价方面,GPU Compute Driver Bench采用标准化评分机制,以上图示意为例:将vendor2作为性能基准,测试用例按特性划分为graph and schedule、memory ops、multi streams三个子类,每个子类基准分设定为1000分。通过加权计算得出各子类综合得分,最终汇总为Total Score,从而为各厂商在整体测试场景下的综合性能提供客观衡量标准。
该工具还支持子测试项目单独运行或批量执行,通过内置的calculateScoreOfSuit.py脚本,开发者可以快速获取当前硬件在各个维度的百分比得分,清晰识别“短板”,并支持与baseline结果对比评估。
快速上手:
三步构建GPU驱动性能实验室
GPU Compute Driver Bench提供了高度自动化的构建流程。为了确保在分析任务调度、内存管理等核心指标时的准确性,请按照以下步骤配置您的开发环境。
第一步,安装系统依赖,信息获取库与数学计算库。
- 运行
sudo apt install libcpuid-dev以安装 libcpuid 以获取一些 CPU 信息。 - 运行
sudo apt-get install libeigen3-dev以安装 Eigen。 - 运行
sudo apt-get install hwloc以安装拓扑图工具。 - 运行
sudo apt install libblas-dev libopenblas-base libopenblas-dev以安装 blas 库。
第二步:快速构建
确保环境已配置MUSA或CUDA Toolkit。使用项目根目录下的build_all.sh 脚本即可快速完成编译。
- 针对摩尔线程MUSA环境:
./build_all.sh -m #启用MCC编译器
- 针对 NVIDIA CUDA 环境:
./build_all.sh -n #启用NVCC编译器
常用选项:使用-jN指定并行编译线程数(默认j12),使用-R进行重新构建。
第三步:代码“零成本”迁移
如果您手头已有基于CUDA的测试案例,我们为您准备了自动化转换工具。进入scripts/目录,利用内置的musify脚本,即可实现从CUDA到MUSA代码的丝滑切换,省去手动重写的繁琐过程。
▼ 进阶技巧 自定义您的编译选项
通过-h参数,开发者可以查看更多灵活的配置选项,例如多核并行编译以缩短构建时间,部分设备功能已预编译。如果要在其他架构上运行,请修改gpu-compute-driver-bench/schedule/elf/gen.sh、重新运行./gen.sh,并-R在运行时指定选项./install.sh。
Usage: ./install.sh [OPTIONS]
Options:
  -R       : Rebuild (clean build directory and rebuild)
  -j N     : Number of parallel jobs formake(default: j12)
  -h       : Display this help message
  -m       : Enable MCC Compiler(default: OFF)
  -n       : Enable NVCC Compiler(default: OFF)
  -d       : Enable Debug Mode(default: OFF)
▼ 如何获得分数
运行测试用例并收集结果:
$ cd scripts/
$ python3 autorun.py -h
usage: autorun.py [-h] [--result RESULT] [--suits {memoryOp,mulStreams,graphAndSchedule} [{memoryOp,mulStreams,graphAndSchedule} ...]]

Run executables and save results.

options:
  -h, --help            show this help message andexit
  --result RESULT       The result directory, default is projectPath/result
  --suits {memoryOp,mulStreams,graphAndSchedule} [{memoryOp,mulStreams,graphAndSchedule} ...]
                        The test suits to run, choose from ['memoryOp', 'mulStreams', 'graphAndSchedule']. Default is all.
▼ 计算得分
$ cd scripts/
$ python3 calculateScoreOfSuit.py -h
usage: calculateScoreOfSuit.py [-h] [--base BASE] [--test TEST] [--score SCORE] [--config CONFIG]

Calculate the score of test cases.

options:
  -h, --help       show this help message andexit
  --base BASE      The basic result table fold, default is ../baseline/
  --test TEST      The test result table fold, default is ../result/
  --score SCORE    The score path, default is projectPath/score
GPU Compute Driver Bench现已基于Apache 2.0协议在GitHub开源。我们诚邀广大开发者参与贡献,共同完善工具功能,推动其持续增强与扩展,以助力全球GPU生态的协同优化与发展。
该工具的发布为驱动开发者提供了精准的性能优化指引,也为系统集成商与应用开发者带来了硬件选型与性能调优的重要参考。这是摩尔线程为全球GPU应用生态发展所做的一项重要贡献。
获取更多摩尔线程GPU Compute Driver Bench开源信息,请点击下方“阅读原文”或访问: