2026年1月9日,TritonNext技术大会在北京隆重举行,摩尔线程编译器首席架构师海纳在会上发表了题为《FlagTree在摩尔线程GPU的适配与优化》的主题报告,展示了摩尔线程基于MUSA架构在Triton计算语言深度适配与优化方面取得的最新突破。作为连接上层计算语言与底层硬件的核心编译平台,FlagTree在此过程中发挥了关键支撑作用。
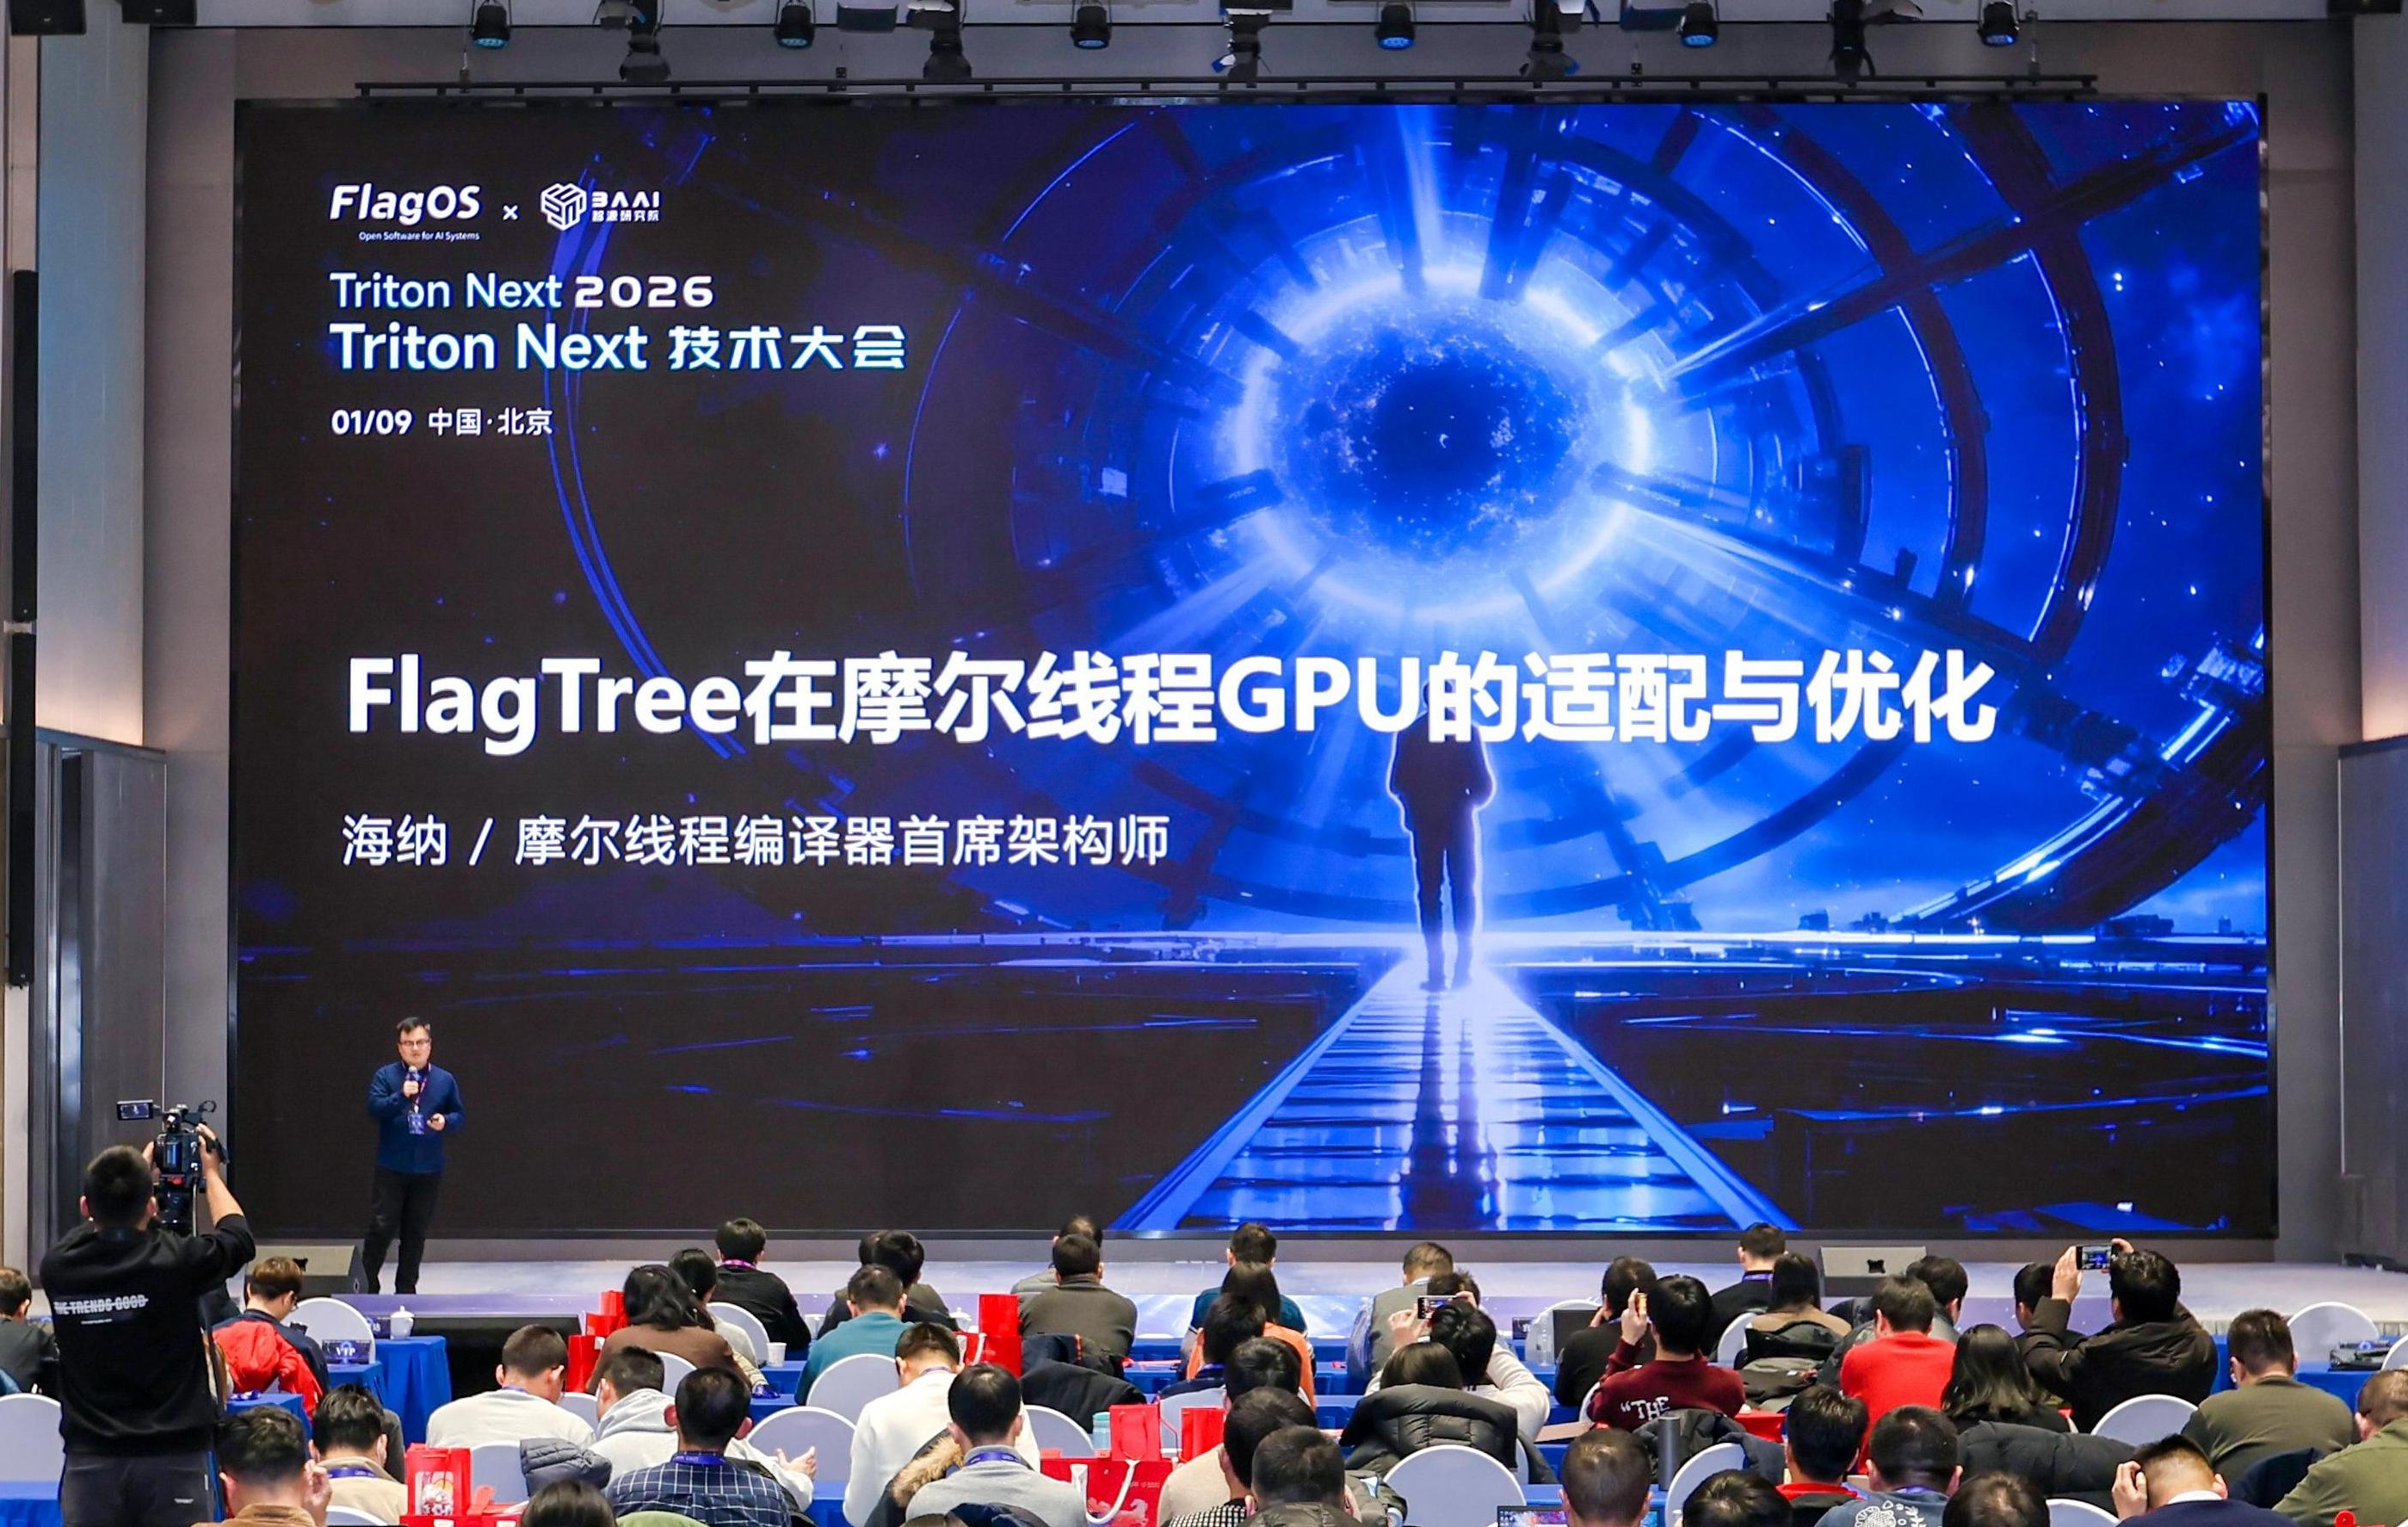
摩尔线程的旗舰级训推一体全功能智算卡MTT S5000已实现对Triton计算语言的深度适配,包括矩阵乘与Linear Layout映射、Warp Specialization(Warp特化)、流水线优化与WASP技术在内的关键技术。这些优化使得开发者无需深入底层硬件细节,即可通过Triton语言实现接近硬件峰值的性能表现。
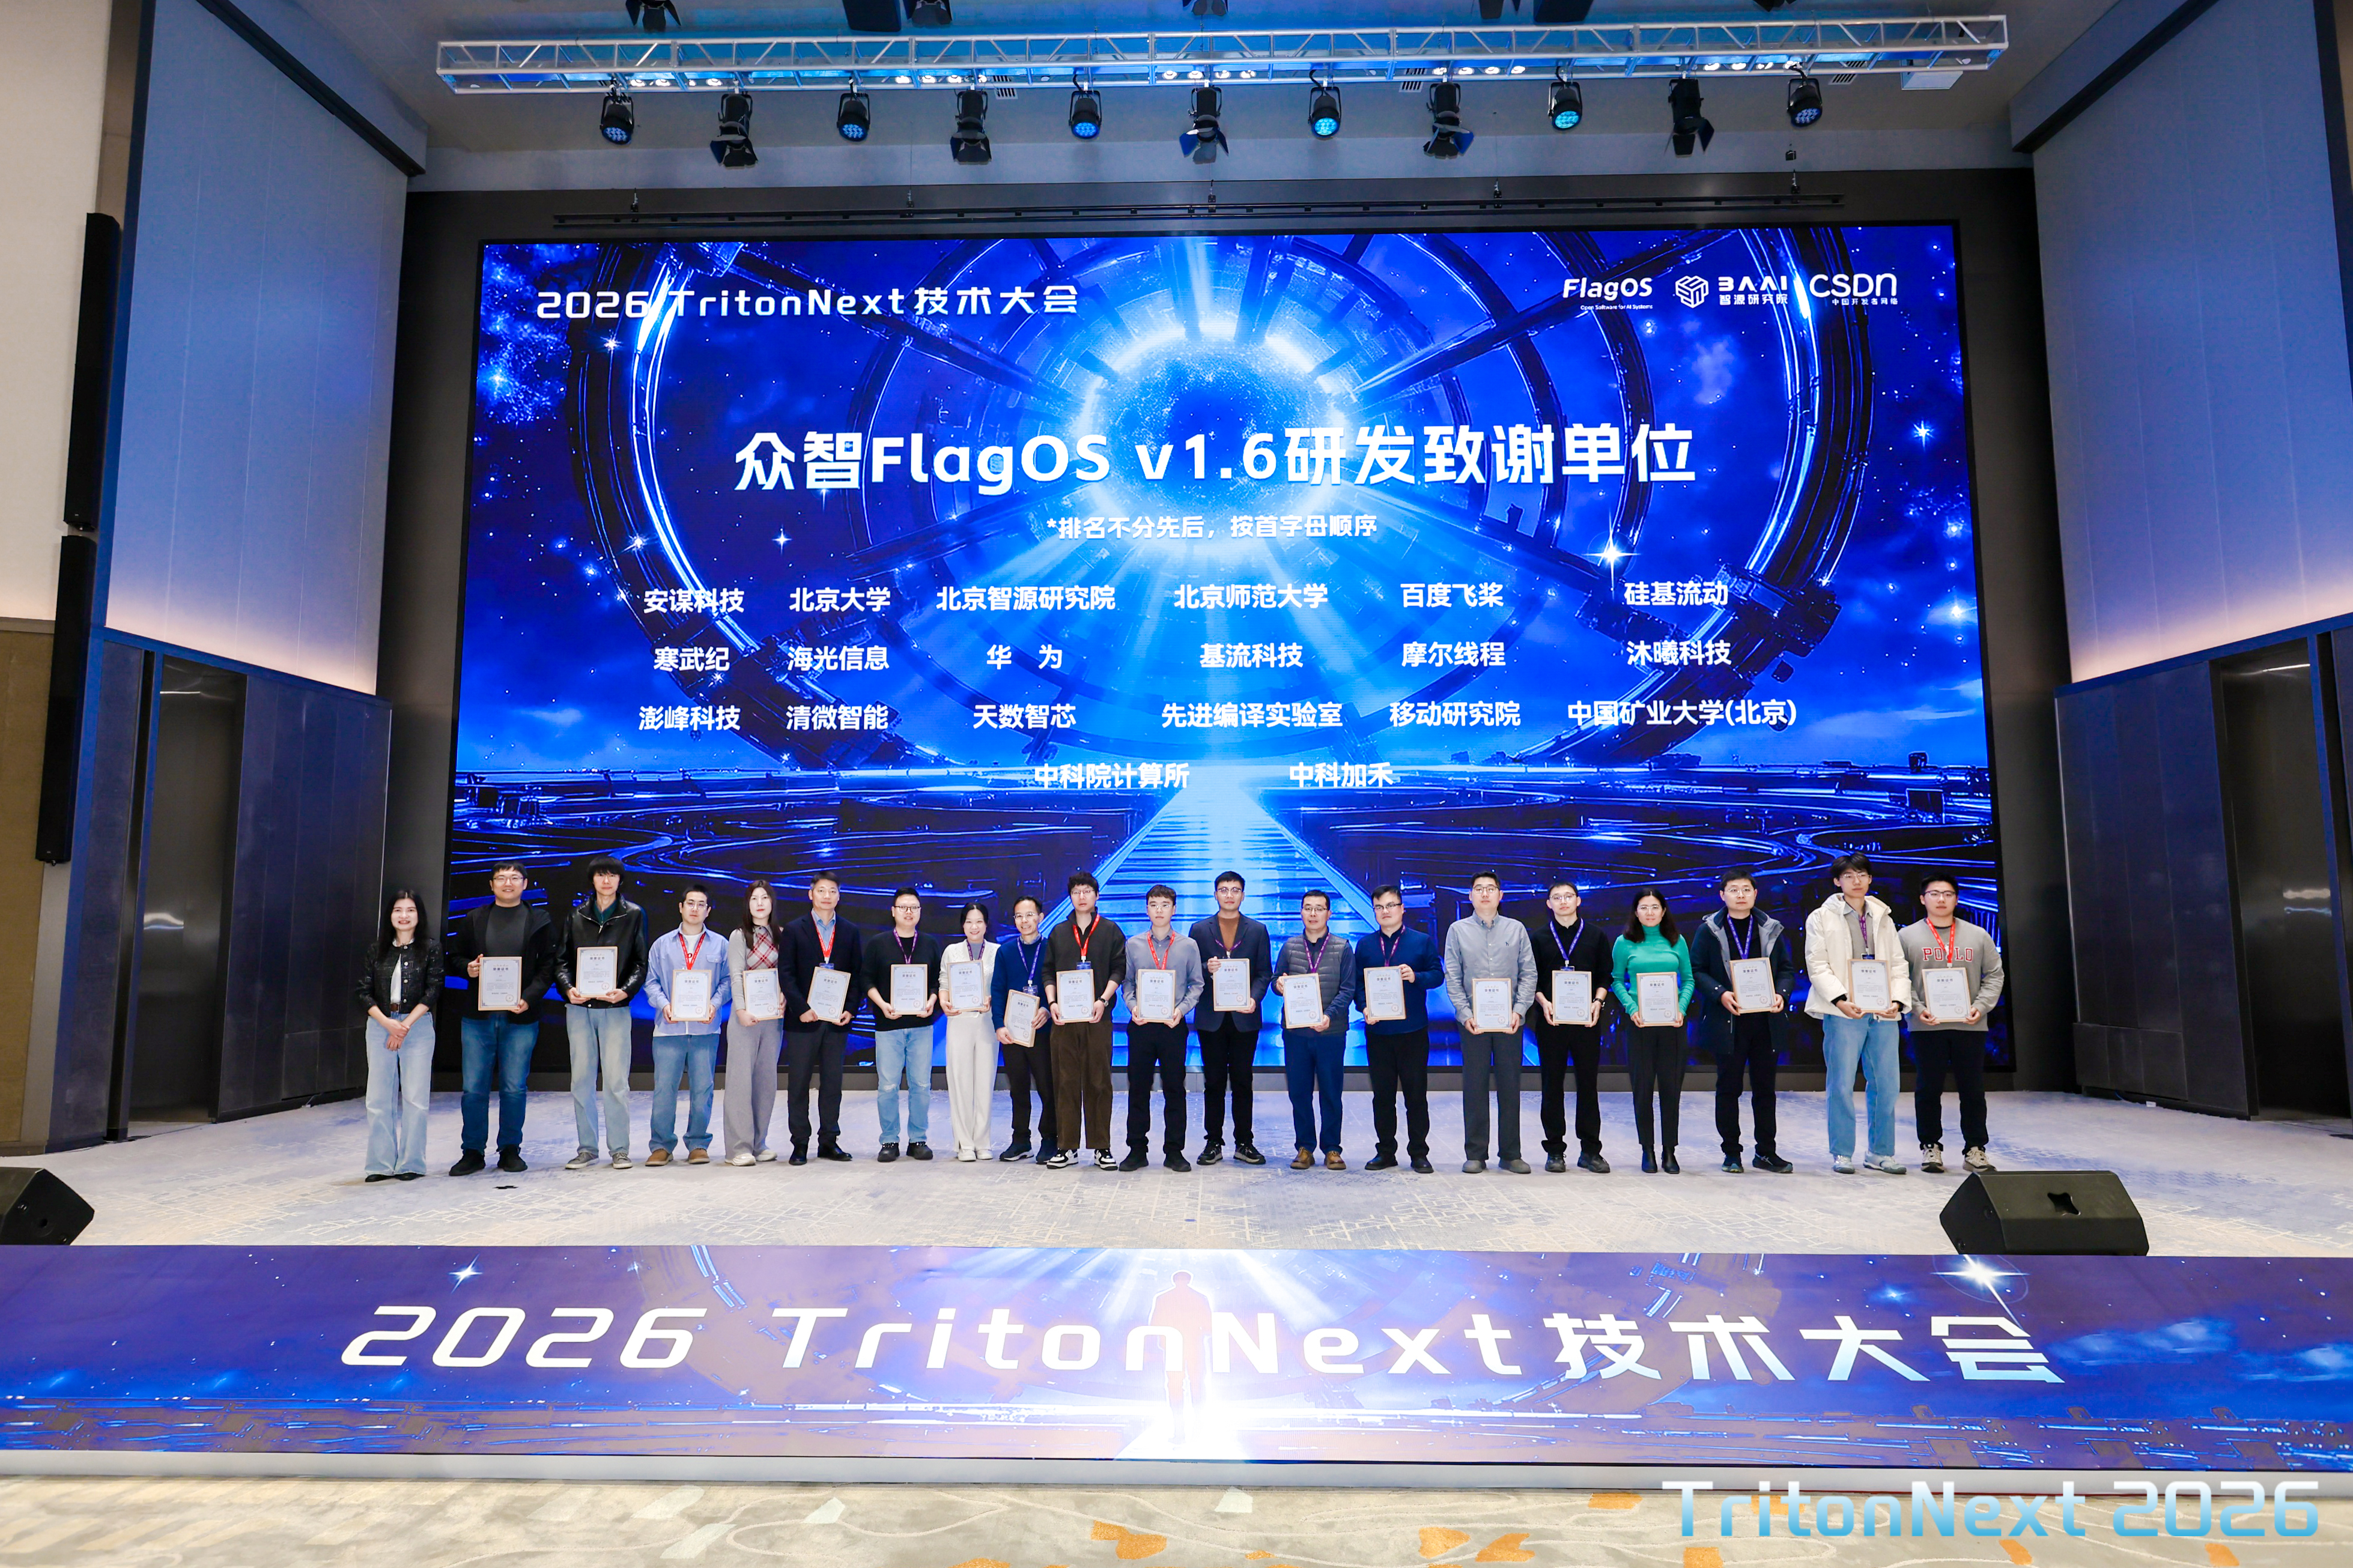
摩尔线程正积极推动开源生态与行业标准化,依托MUSA软件栈,深度适配并融入了由智源研究院主导的FlagOS开源系统。此前,北京智源人工智能研究院发布了面向多种AI芯片的系统软件栈——众智FlagOS 1.6,摩尔线程作为深度融入FlagOS生态的国产全功能GPU厂商,在TritonNext 2026大会上被授予相关荣誉。
FlagOS是面向多芯片架构、多场景需求的标准化AI性能基准与系统化支撑体系,致力于通过自动化测试与统一评估框架,构建开放、公平、高效的软硬件协同生态。基于FlagOS,摩尔线程在如下方面取得了实质性进展:
- 算子适配:MUSA已实现对高性能通用算子库FlagGems的快速适配,在算子支持覆盖率与平均执行性能上均位居行业前列;
- 性能验证:摩尔线程已向AI性能基准测试FlagPerf提交代码,并在MTT S5000上完成了端到端的标准化性能验证;
- 分布式支持:MUSA已完成对大模型分布式推理与训练框架FlagScale的适配,MTT S5000能够高效执行编译与任务调度,为大规模AI应用的部署提供有力支撑。
目前,摩尔线程MUSA软件栈已全面支持MUSA C、Triton及TileLang等多种编程模型,为AI开发者提供了高效、灵活的全功能GPU开发环境。此次技术分享,充分展示了国产计算生态在软硬件协同设计与性能优化方面的持续突破。摩尔线程将持续通过底层技术创新与开放生态建设,加速推进国产全功能GPU的标准化、易用化进程,助力开发者更高效地释放国产算力潜能,共同推动人工智能产业高质量发展。