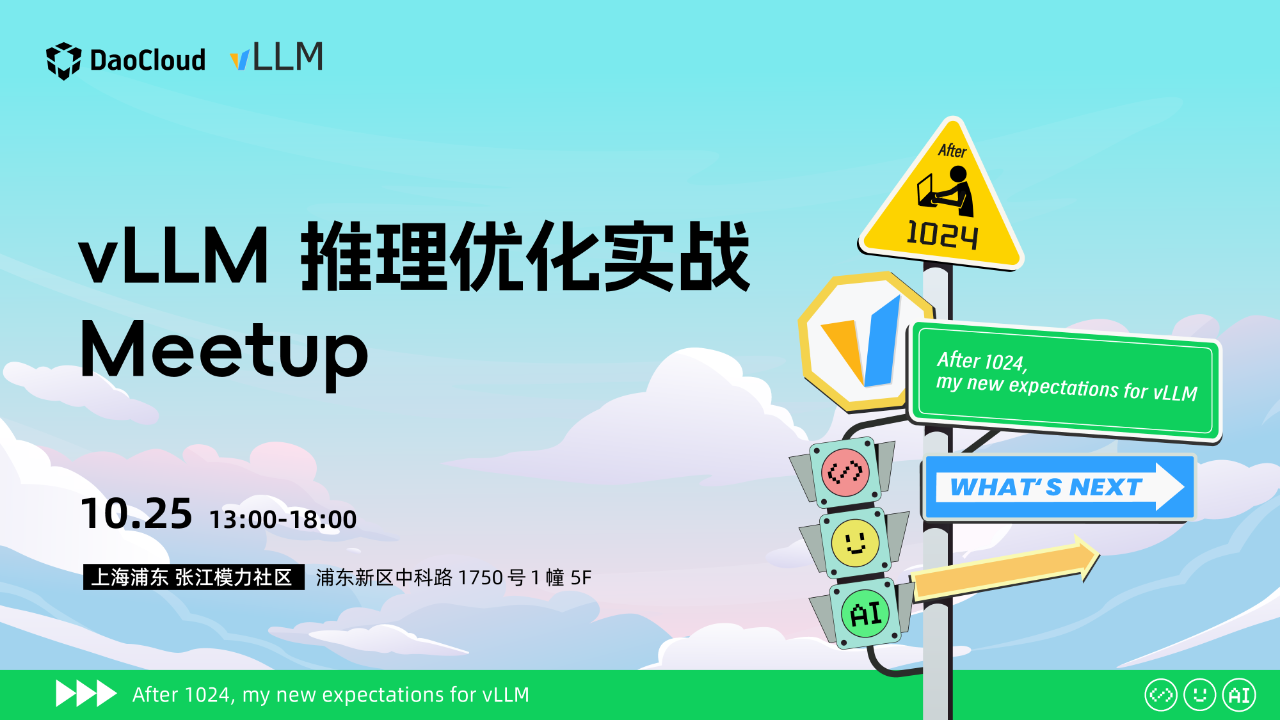
近日,由「DaoCloud 道客」与vLLM社区联合举办的Meetup在上海成功举行。活动吸引了数百名开发者到场交流,线上观看超3000人次,现场围绕vLLM推理优化这一热门话题展开了深入探讨。
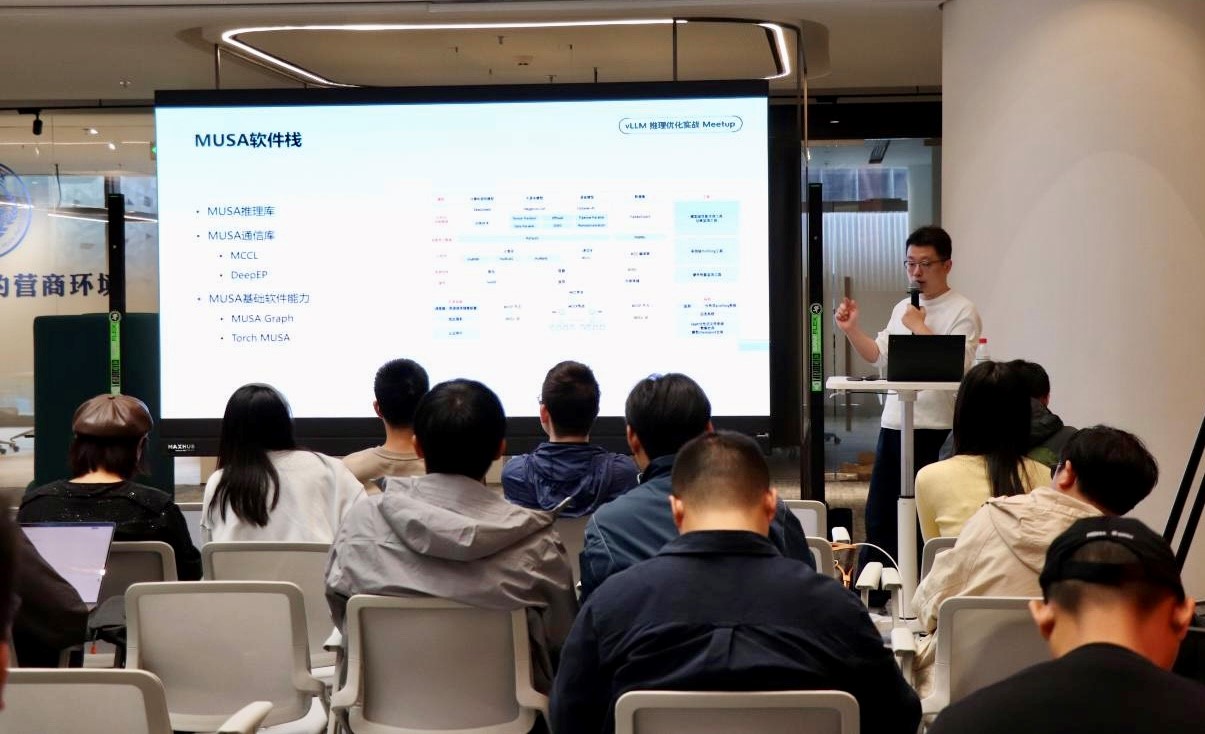
摩尔线程的技术代表薛磊在会上分享了vLLM推理引擎在摩尔线程MUSA架构GPU上的适配与优化实践。他提到,团队通过插件化机制,优化了Flash Attention、DeepGEMM等关键算子,并集成MCCL、DeepEP等自研通信库,有效提升了计算效率。在分布式推理方面,还提出了PD分离、Mooncake KVCache传输引擎、专家并行(EP)与DeepEP通信优化等策略,以突破互联带宽瓶颈,从而提升MoE模型在国产智算集群上的性能表现。 目前,摩尔线程全功能GPU已实现在vLLM等先进框架上的高性能推理,这为构建自主可控的国产AI算力生态奠定了坚实基础。 活动现场,来自阿里云、上海交通大学、「DaoCloud 道客」的技术专家也分享了相关实践与见解。未来,摩尔线程期待与广大开发者继续携手,共同推进AI推理技术迈向更成熟、更实用的新阶段。