▼ 关注摩尔线程开发者公众号,及时获取摩尔线程开发者各类服务信息 ▼
在当今爆发式增长的AI开源生态中,PyTorch凭借灵活易用的特性,已成为深度学习框架的实施标准。无论是大语言模型推理框架SGLang、vLLM,还是创意流工具ComfyUI,其代码逻辑均深度锚定于PyTorch的GPU接口torch.cuda.*,用于完成GPU设备管理、显存分配与核心计算调度。
然而,这种以特定硬件为默认后端的技术惯性,却成为国产算力落地的隐形壁垒。开发者欲想将成熟项目迁移至国产GPU,往往需面对大量代码适配工作。这不仅是一场耗时耗力的“人力工程”,更是生态融合过程中高昂的代价。
torchada
定义“零成本”迁移的新范式
面对这一核心痛点,摩尔线程推出了torchada适配器。它本质上是一个源代码级的兼容层,在Python运行时层面将代码中的torch.cuda.调用动态适配为等效的torch.musa.调用。基于PyTorch标准接口编写的代码,无需修改即可运行在摩尔线程GPU上,开发者只需在代码入口处添加一行import torchada,即可完成整个迁移过程。
以SGLang为例,其代码库中存在大量torch.cuda.调用,涵盖设备管理、显存分配、混合精度训练、分布式通信等各个方面。若手动逐一替换为torch.musa.,不仅需要深入理解项目每个模块,还必须确保修改后的功能完全等价。类似的情况在vLLM、ComfyUI、LightLLM等项目中同样普遍存在。
torchada致力于让开发者以极低的代码迁移成本,将现有的PyTorch项目平滑部署至摩尔线程全功能GPU。它在国产计算平台与主流通用计算生态之间搭建了一座高效的桥梁,让开发者得以从繁琐的底层适配中解放出来,将精力聚焦于算法创新与业务验证。
torchada具备以下核心特性:
▼零代码改动:
只需使用import torchada,现有基于PyTorch CUDA接口的业务逻辑代码即可运行在摩尔线程全功能GPU上。
▼全面的API兼容:
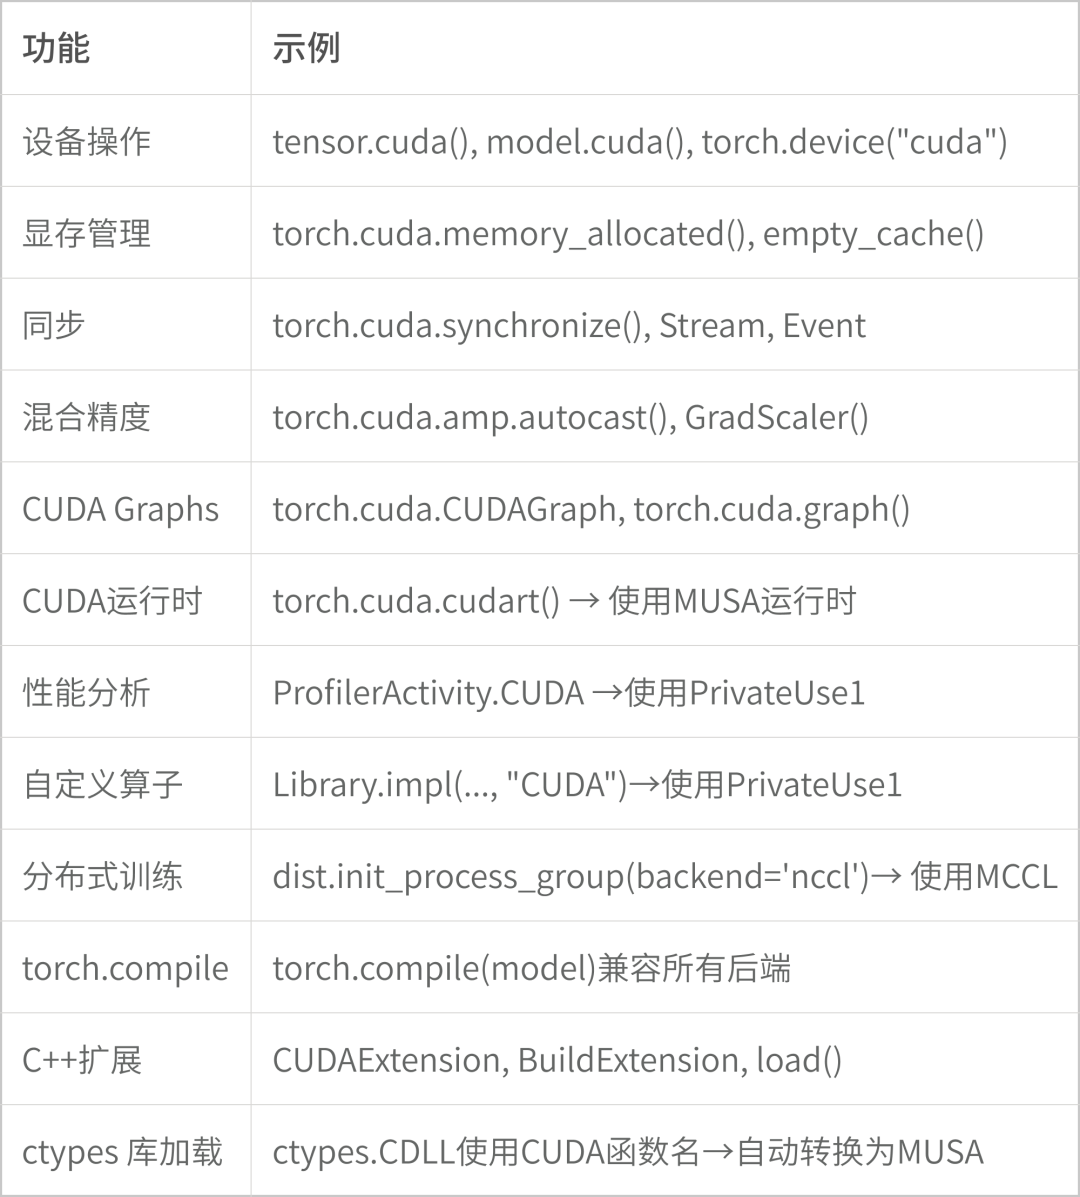
支持设备操作、显存管理、同步与流式处理(Synchronization, Stream/Event)、混合精度训练、CUDA Graphs、分布式训练、torch.compile动态编译及C++扩展等核心功能。
▼极低损耗:
采用激进的缓存策略,高频调用路径的开销可控制在200纳秒以内。
▼自动符号兼容:
构建C++扩展时,自动将CUDA符号(如cudaMalloc、cudaStream_t)转换为MUSA等效符号(如musaMalloc、musaStream_t),内置380余条规则。
▼ctypes库加载兼容:
自动转换ctypes加载的动态库中的CUDA函数名为 MUSA 函数名。
torchada功能:
极简安装
一分钟上手torchada
使用torchada需要两个前置条件:
安装torch_musa,以提供PyTorch的MUSA支持。请前往GitHub了解torch_musa的安装使用 https://github.com/MooreThreads/torch_musa
已安装正确驱动的摩尔线程GPU。
在前置条件都满足后,可以通过pip install torchada命令安装torchada,或从GitHub仓库源码安装。安装代码示例如下:
pip install torchada
#或从源码安装
git clone https://github.com/MooreThreads/torchada.git
cd torchada
pip install -e .
使用torchada非常简单,只需在代码顶部添加一行导入语句import torchada,即可运行现有的CUDA代码:
import torchada #在文件顶部添加这一行
import torch
#现有的CUDA代码无需任何改动
x=torch.randn(10, 10).cuda()
print(torch.cuda.device_count())
torch.cuda.synchronize()
在完成上述步骤后,所有torch.cuda. API会自动重定向到torch.musa.。
典型场景
业务代码零改动
下面通过几个典型场景来展示torchada的使用方式。在所有场景中,业务逻辑代码与主流通用计算生态的原生开发完全一致,唯一的区别仅仅是在入口处多了一行import torchada。
训练场景:混合精度+分布式
在实际的模型训练中,混合精度和分布式是两个最常用的特性。torchada对二者都提供了完整的支持:
import torchada
import torch
import torch.distributed as dist
#分布式初始化:'nccl'会自动适配为摩尔线程的'mccl'
dist.init_process_group(backend='nccl')
model = MyModel().cuda()
scaler = torch.cuda.amp.GradScaler()
#混合精度训练:autocast和GradScaler正常工作
with torch.cuda.amp.autocast():
    output = model(data.cuda())
    loss = criterion(output, target.cuda())
scaler.scale(loss).backward()
scaler.step(optimizer)
scaler.update()
推理优化:CUDA Graphs + torch.compile
对于追求极致推理性能的场景,CUDA Graphs和torch.compile可以无缝使用:
import torchada
import torch
# 使用 torch.compile 加速
compiled_model = torch.compile(model.cuda(), backend='inductor')
# 使用CUDA Graphs减少内核启动开销
g = torch.cuda.CUDAGraph()
with torch.cuda.graph(cuda_graph=g):
    y = compiled_model(x)
扩展开发:C++扩展与自定义算子
很多高性能项目会使用C++扩展来实现自定义CUDA内核。torchada在构建阶段自动将CUDA符号(如cudaMalloc、cudaStream_t、at::cuda)转换为MUSA等效符号,内置380多条规则:
import torchada#必须在torch.utils.cpp_extension之前导入
from torch.utils.cpp_extension import CUDAExtension, BuildExtension
# 标准CUDAExtension 可直接使用—torchada 自动处理CUDA→MUSA 转换
ext = CUDAExtension("my_ext", sources=["kernel.cu"])
通过torch.library注册的自定义算子也能够在MUSA环境下正常工作:
import torchada
import torch
my_lib = torch.library.Library("my_lib", "DEF")
my_lib.define("my_op(Tensor x) -> Tensor")
my_lib.impl("my_op", my_func, "CUDA") #在MUSA上也能工作
调试和分析:Profiler+ctypes
在性能调优阶段,torchada也包含了ProfilerActivity.CUDA和ctype库加载:
import torchada
import torch
#性能分析:ProfilerActivity.CUDA在MUSA上也能工作
with torch.profiler.profile(
    activities=[torch.profiler.ProfilerActivity.CPU, torch.profiler.ProfilerActivity.CUDA]
) as prof:
    model(x)
还有如下自动转换功能:
import torchada
import ctypes
# ctypes 加载动态库时,CUDA函数名自动转换为MUSA函数名
lib=ctypes.CDLL("libmusart.so")
func=lib.cudaMalloc #自动转换为musaMalloc
平台检测
当用户需要在代码中区分当前运行在主流通用计算生态GPU还是摩尔线程GPU上时,torchada提供了便捷的API:
import torchada
from torchada import detect_platform, Platform
platform = detect_platform()
if platform == Platform.MUSA:
    print("在摩尔线程GPU上运行")
目前torchada已成功适配大语言模型推理服务(如 SGLang、vLLM、Xinference、LightLLM、赤兔),图像/视频生成工具(如 LightX2V、ComfyUI)等多个基于 PyTorch 的开源项目,证明了该工具在实际生产环境中的可靠性和通用性。
性能实测
开销低于200ns
torchada采用激进的缓存策略来最小化运行时开销,实测数据显示,所有高频API调用的开销均控制在200纳秒以内:
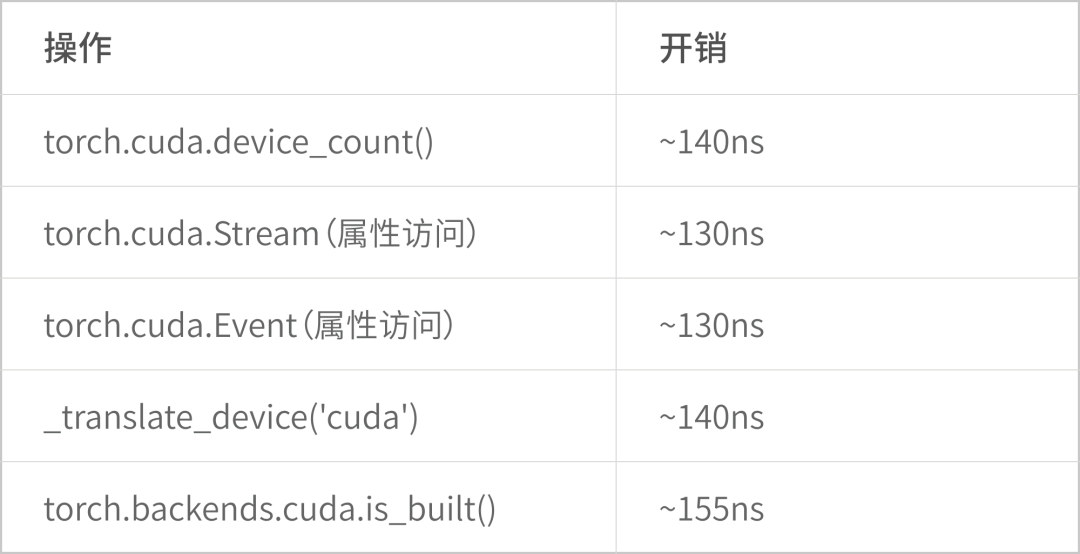
*数据来自摩尔线程实验室
作为对比,典型的GPU内核启动耗时在5,000~20,000 ns之间。torchada的适配层开销仅为其百分之一量级,对于实际生产环境而言可以忽略不计。
torchada
跨平台生态的关键桥梁
总的来说,torchada通过一个轻量级的运行时适配层,在几乎不产生性能损耗的前提下,自动、精准地将标准的torch.cuda.调用兼容为等价的torch.musa.操作。其意义在于:
▼释放开发者生产力:
开发者无需再投入数月时间进行繁琐、易错的手动代码替换,从而能将宝贵精力聚焦于模型创新、性能调优与应用落地本身。
▼实现生态资产的零损继承:
企业或研究者基于CUDA生态积累的庞大代码库、预训练模型及成熟工作流,得以近乎“原封不动”地在摩尔线程全功能GPU上运行,极大保护了既往投资,并显著加速了新平台的验证和落地过程。
▼促进生态融合:
torchada为PyTorch社区提供了一条平滑的过渡路径。开源项目维护者无需维护CUDA和MUSA两套独立的代码分支,只需通过条件导入集成torchada,即可轻松扩展其对国产硬件的支持,这有助于凝聚社区力量,促进生态融合。
torchada显著降低了生态迁移的技术门槛。它不只是一款技术工具,更是摩尔线程推动国产算力底层架构多元化、实现AI基础设施生态健康发展的战略支点。
了解torchada操作指南、开源项目和实战案例等更多信息,请访问:
▼摩尔线程博客:
https://blog.mthreads.com/blog/musa/2026-02-25-torchada/
▼摩尔线程GitHub官方仓库: