近日,摩尔线程正式发布TensorFlow-MUSA v1.5.0。该工具是面向MUSA统一系统架构GPU的TensorFlow插件,通过将MUSA设备注册为TensorFlow原生设备,使开发者能够在摩尔线程全功能GPU上直接进行AI模型的训练与推理任务,无需修改原有模型代码。
基于摩尔线程AI训推一体智算卡MTT S5000的实测数据显示,在TokenMixerLarge等前沿搜广推模型的训练中,训练吞吐相较国际主流GPU可提升1.5倍至1.85倍。
本次版本重点针对TensorFlow应用最广泛的搜索、广告、推荐(以下简称“搜广推”)核心场景进行深度优化与专项支持,全面兼容Wide&Deep、DeepFM、DCN、DIN、MMoE等经典模型,以及Wukong、RankMixer、OneTrans、TokenMixerLarge等前沿新架构模型。目前该版本已在GitHub开源,并提供预构建镜像供开发者直接使用。
搜广推场景的框架挑战
搜广推是互联网平台连接用户与内容的核心业务,依托海量用户行为数据与大规模稀疏特征运行,其算力需求特征与通用视觉、语音任务存在显著差异:Embedding参数体量庞大、结构迭代频繁,训练需要高吞吐分布式能力,线上推理对时延和吞吐要求严苛,且训推共用一套代码与工程链路。因此,对深度学习框架的算子覆盖度、混合精度支持及分布式性能有着极高标准。
长期以来,国内搜广推业务高度依赖TensorFlow、PyTorch等海外深度学习生态,且大多运行于非国产计算平台。向国产算力迁移时,框架兼容性不足、算子完备性欠缺、迁移成本较高,是常见的几类问题。TensorFlow-MUSA在框架层完整对齐TensorFlow数据流图、自动微分、分布式训练等核心机制,实现MUSA设备的原生集成,使搜广推团队能够将原有TensorFlow工程迁移至摩尔线程全功能GPU上运行,降低迁移过程中的工程成本。
核心能力与模型矩阵
TensorFlow-MUSA v1.5在保持ResNet等经典视觉、语音模型支持的基础上,将能力重心聚焦于搜广推场景,重点完善该场景所需模型的框架支持。开发者可直接调用MUSA加速能力完成模型训练与推理,完整沿用TensorFlow原有的数据流图、自动微分与分布式训练机制,开发方式与在既有TensorFlow环境保持一致。
兼容性方面,TensorFlow-MUSA v1.5同时支持TensorFlow 2.6.1和2.15.1,两个版本均可配合MUSA SDK 4.3.5或5.1.0使用。鉴于TensorFlow 2.15.1之后版本的功能增量有限,且移除了tf.estimator等早期特性,摩尔线程后续将主要维护TensorFlow 2.15.1版本,保持前向兼容,同时根据开发者反馈评估其他版本的支持需求。
模型能否直接运行,是搜广推团队评估框架的关键维度。TensorFlow-MUSA v1.5已提供从经典到前沿的完整模型矩阵:
▼搜广推经典模型:WDL、FNN、PNN、DeepFM、NFM、MLR、SharedBottom
▼ 特征交叉深化模型:DCN、xDeepFM、AutoInt、FGCNN、FiBiNet、FWFM
▼ 用户行为序列建模及多任务模型:DIN、DIEN、DSIN、BST、MMoE、ESMM、PLE
▼ 前沿新架构模型:EDCN、DCNmix、Wukong、RankMixer、OneTrans、TokenMixerLarge
更多模型支持信息,请访问摩尔线程GitHub官方仓库。
实测性能与快速上手
得益于摩尔线程全功能GPU在BF16、TF32等数据精度上的支持,以及TensorFlow-MUSA v1.5在多流执行、算子融合与图优化、XLA编译优化等层面的针对性增强,摩尔线程AI训推一体智算卡MTT S5000在搜广推模型训练中表现出了明显的性能优势。
如下表实测数据所示,以前沿新架构模型TokenMixerLarge为例,其单步训练耗时138.048ms,相较国际主流GPU加速比达到1.81倍,且训练过程中耗时稳定、波动较小。
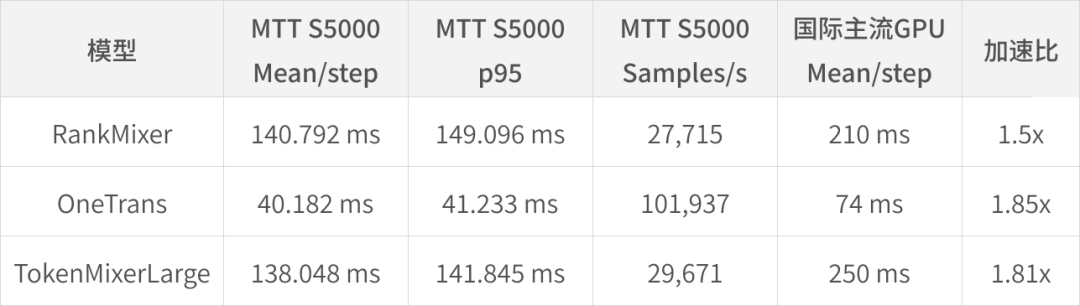
*以上测试数据来自摩尔线程实验室。测试基于TensorFlow 2.15.1、Python 3.10.20、mixed BF16、batch size 4096环境,tensorflow_musa_extension提交版本为546d40c,XLA未启用。数据仅供参考,实际结果会受模型实现、硬件配置、软件版本与训练参数影响。
TensorFlow-MUSA v1.5.0已在GitHub开源发布,开发者可根据官方说明编译安装,或直接拉取预构建镜像使用。
▼GitHub
https://github.com/MooreThreads/tensorflow_musa_extension/releases/tag/v1.5.0
▼示例代码
https://gitee.com/mthreadsacademy/tensorflow_musa_playground
▼官方镜像(MUSA SDK 5.1.0)
registry.mthreads.com/presale/devtech/tensorflow_musa:20260623
▼官方镜像(MUSA SDK 4.3.5)
registry.mthreads.com/presale/devtech/tensorflow_musa:4.3.5_20260624
夯实深度学习框架生态
TensorFlow-MUSA的发布,是摩尔线程在模型训练与推理框架生态建设中的又一重要进展。
摩尔线程正系统性地构建全链路技术栈:框架层,Torch-MUSA作为PyTorch的MUSA扩展库,为大模型训练与推理提供高效、可靠的底层支持;推理层,SGLang-MUSA完成主线合入,vLLM-MUSA实现深度整合;通信层,Mooncake MUSA预编译包打通了KV Cache跨节点传输。国产GPU训练与推理全链路的技术能力正在不断深化。
摩尔线程将持续深耕训练与推理技术栈,携手开发者与开源社区,推动国产算力在更多AI商业化场景中释放价值。