近日,摩尔线程在国产GPU厂商中率先构建了KV Cache数据平面方案——MUSA统一系统架构(以下简称MUSA)的MUSA后端正式合入开源KV Cache中间件LMCache官方主线。LMCache自v0.4.7版本起将MUSA纳入后端支持,至v0.5.5rc5版本MUSA已完成全场景能力适配。
依托Torch-MUSA IPC跨进程通信能力与自研KV算子库MUSA-Aiter,MUSA在LMCache中实现了同节点跨进程的KV Cache零拷贝共享——让KV Cache不再局限于单个请求或进程,而是成为整个系统可按需查找和复用的共享资源,从而显著提升长文本推理效率。vLLM与SGLang均已原生支持MUSA,开发者可通过LMCache官方主线直接调用完整的MUSA软件栈,有效降低模型迁移与部署成本。
长文本推理的缓存之困
大模型自回归推理分为Prefill与Decode两个阶段。Prefill阶段并行处理输入Prompt,逐层计算注意力,并将每一层生成的Key与Value存入缓存;Decode阶段逐Token生成,每生成一个新Token都需要读取此前全部Token的Key与Value。KV Cache的核心作用是以显存空间换取计算效率——通过缓存历史数据,让Decode阶段仅需计算当前Token的注意力,避免历史Token的注意力在每个解码步被反复计算,从而大幅提升推理速度。
上下文越长、并发请求越多,KV Cache显存占用量随Token数量线性增长。在长文本阅读、Agent多轮对话、RAG检索增强生成等场景中,相同前缀被反复计算,显存资源紧张与首Token延迟过高的现象尤为明显。当前长上下文推理的核心矛盾,已从算力不足转向缓存放不下、数据搬不快、管理效率低。
三层接口协同合入主线
MUSA软件栈是覆盖运行时、编程模型、框架和算子库的完整技术体系,本次对LMCache的合入并非简单的功能兼容,而是实现了缓存复用、跨进程共享与分层存储的系统化能力。LMCache采用控制平面与数据平面分离的架构,MUSA围绕其数据路径,以三层接口协同完成原生优化。
▼ 框架与内存层:Torch-MUSA IPC实现跨进程Tensor级共享
在LMCache多进程架构中,KV Cache的生成者与消费者可能位于同一节点的不同进程。为解决跨进程数据共享的效率问题,摩尔线程Torch-MUSA IPC 提供了一套基于 PyTorch 风格的 API,用于在 MUSA 设备上进行跨进程的高效数据共享,其核心功能体现在以下两个层面:
• Memory IPC:通过传递内存句柄与视图元数据,使LMCache server进程直接映射并访问worker进程中的MUSA KV Cache,让消费者映射同一底层显存并重建完整Tensor视图,实现跨进程“零拷贝”,有效避免数据复制开销。
• Event IPC:通过跨进程的事件同步机制,在生产者与消费者之间建立正确的执行序,将内存共享与执行同步解耦,确保数据就绪后再发起访问,避免数据竞争,使数据传输的时序控制更加清晰可靠。
两者协同,将底层Runtime能力提升为可保留任意Tensor视图、显式管理接收端生命周期的PyTorch语义。这种Tensor级共享机制为多进程KV Cache系统提供了清晰的共享接口,相比传统方式的数据复制步骤减少50%,降低了长文本推理场景中的传输延迟。
▼ 算子层:MUSA-Aiter提供分页感知的KV搬运
除了FlashAttention、FlashMLA与GEMM等热点计算算子外,LMCache关键路径中还存在另一类工作:在推理引擎的分页KV Cache与连续传输缓冲区之间执行gather/scatter。
作为摩尔线程自研KV算子库,MUSA-Aiter的KV transfer接口面向vLLM、SGLang与LMCache的数据布局,提供分页感知的原生搬运能力——理解分页KV Cache与连续Chunk之间的布局差异,按slot_mapping直接执行gather/scatter,并支持MHA/GQA与MLA多种缓存布局。其按行搬运的向量化快路径减少了索引解析与中间打包开销,让缓存命中路径快于重算。更快的缓存命中路径,直接转化为更低的TTFT和更高的吞吐。
▼缓存编排层:LMCache统一管理缓存生命周期
LMCache集中负责缓存键管理、命中判断、位置目录与淘汰策略,热层置于显存、温层落至主机内存、冷层放至远端存储,使缓存策略独立于推理引擎演进,无需为不同引擎分别维护缓存逻辑。合理的分层放置确保热数据常驻显存,减少远端访问带来的延迟波动,使长文本推理在缓存复用场景中获得稳定的效率提升。
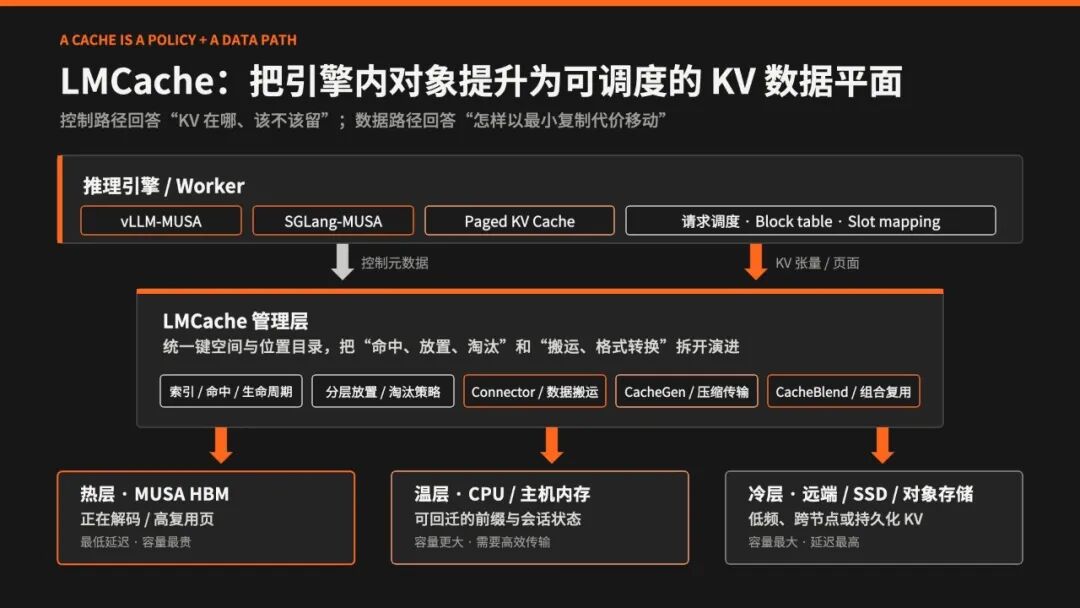
图:LMCache 数据平面——控制路径与数据路径分离,热温冷分层放置
三层协同使基于MUSA的长文本推理拥有了持续优化命中率、传输效率与资源利用率的系统基础。其中,Torch-MUSA IPC提供跨进程零拷贝;MUSA-Aiter以分页感知的KV搬运优化关键数据路径;LMCache通过分层存储与统一缓存管理,使缓存策略独立于推理引擎演进。当跨进程内存语义、设备算子与缓存管理形成闭环,长文本推理效率的提升便有了从架构层面持续迭代的根基。
释放KV Cache系统级能力
KV Cache基础设施是长文本推理规模化落地的关键一环。LMCache的定位是面向多推理引擎的KV Cache层,旨在为不同推理引擎提供可复用的缓存基础能力。此次合入主线,意味着MUSA不再需要为vLLM和SGLang各自维护独立的缓存适配补丁,而是统一走同一条上游路径,从根本上消除了各推理引擎独立适配时的维护偏差。
MUSA合入LMCache主线后,开发者基于官方主线即可使MUSA设备融入这两条主流推理栈的缓存体系,与上游生态保持同步。LMCache带来的TTFT降低与吞吐提升,在长文本阅读、多轮对话、RAG等场景中尤为显著,进一步释放了MUSA在长文本推理场景中的性能潜力。
除LMCache外,Mooncake Transfer Engine已与MUSA深度集成,支撑Prefill-Decode分离架构下的跨节点KV传输。同时,Tair KVCache也已纳入MUSA生态,作为全局KVCache管理面组件,提供统一的元数据管理与缓存调度服务。三者共同构成从单机缓存复用、跨节点高速传输到全局缓存调度的完整能力矩阵,为长文本推理提供系统级基础设施支撑,让 KV Cache 成为可复用、可迁移的推理基础设施。
未来,摩尔线程将持续依托MUSA统一系统架构,在长文本推理、Agent交互等AI核心场景中释放更大价值。
LMCache主线版本v0.5.5rc5-musa:
https://github.com/LMCache/LMCache/releases/tag/v0.5.5rc5-musa
*以上测试数据来自摩尔线程实验室。