API 文档
在线手册
说明:
以下请求的请求头中必须包含 Authorization: .
用真实值替换,可向管理员申请
TTS(Text2Speech)
支持音色
| 音色 | 性别 | 类型 | voice_name |
|---|---|---|---|
| BabyX | 男 | TTS+VC | babyx |
| BoyTen | 男 | TTS+VC | boyten |
| 穆莎(安迪) | 女 | TTS | SSB3001 |
| 米塔 | 女 | TTS | SSB3002 |
HTTP API
http://api.mthreads.com
接口说明
/tts/api/v1/generate
请求参数
类型:json
{
    "text": "这是一个端到端的中文语音合成系统",
    "voice": "boyten",
    "format": "wav",
    "sample_rate": 22050,
    "volume": 50,
    "speech_rate": 0,
    "pitch_rate": 0,
    "energy_rate": 0
}
返回结果
音频数据
请求示例
curl --location 'http://api.mthreads.com/tts/api/v1/generate' \
--header 'Content-Type: application/json' \
--header 'Authorization: Your token' \
--data '{
    "text": "这是一个端到端的中文语音合成系统",
    "voice": "boyten",
    "format": "wav",
    "sample_rate": 22050,
    "volume": 50,
    "speech_rate": 0,
    "pitch_rate": 0,
    "energy_rate": 0
}'
Grpc Endpoint
api.mthreads.com:53966
Proto
文件包:
参数说明
详细说明见proto注释
时序图
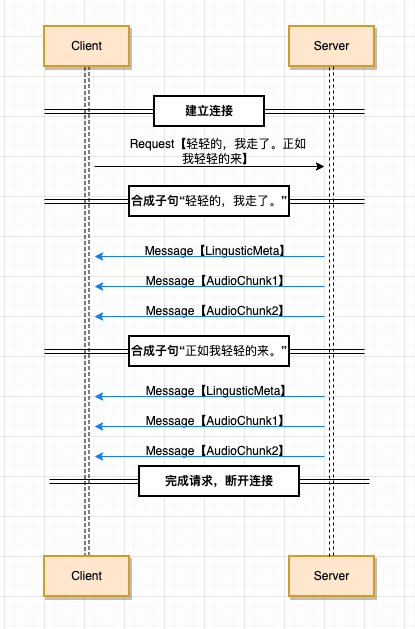
一次tts请求的处理时序如下:
示例代码
文件包
示例代码
# 解压文件
unzip tts_grpc_client.zip && cd tts_grpc_client
# 配置python环境
pip install -i https://pypi.tuna.tsinghua.edu.cn/simple protobuf==3.20.1 grpcio==1.42.0 --ignore-installed
# 发送请求
python3 grpc_client.py --address '101.200.38.222:60377' --voice 'boyten' --text '轻轻的,我走了。正如我轻轻的来'
收到第1子句的语言学时间戳信息(0.0 -> 1.89).
收到第1子句的第1段音频,音频长度1.8905215419501133s
收到第2子句的语言学时间戳信息(1.89 -> 3.523).
收到第2子句的第1段音频,音频长度1.6351020408163266s
dump synthesized audio [3.52562358276644]s to path ./gRPCClient.wav
dump synthesized linguistic meta to path [./gRPCClient.csv]
流式ASR(Automatic Speech Recognition)
流式ASR使用WebSocket接口
使用要求
| 内容 | 说明 |
|---|---|
| 发送格式 | 音频数据采用二进制格式,其余采用文本格式发送json数据 |
| 响应格式 | 以文本格式返回json数据 |
| 音频数据属性 | 采样率16k、单声道;使用PCM格式时,位长16bit |
| 音频格式 | PCM(无压缩的PCM或WAV音频流) 采用PCM格式时,音频需满足采样率16k、位长16bit、单声道;其他格式需满足采样率16k、单声道 |
| 数据发送 | 建议音频流每160ms发送一次,每次发送160ms的数据 建立请求后,数据发送间隔不能超过10s。若长时间为发送数据(超过10s),服务会返回错误消息并结束识别 如果用户发送数据过快,可能导致引擎出现过载错误 |
WebSocket URL
wss://api.mthreads.com/api/v1/asr
鉴权方式
在WebSocket连接的连接头(header)中加入:
{"Authorization": your_token}交互流程
在流式识别中,随着用户传输数据,服务端不断返回结果,直到用户发送StopTranscription后,服务端返回TranscriptionCompleted。
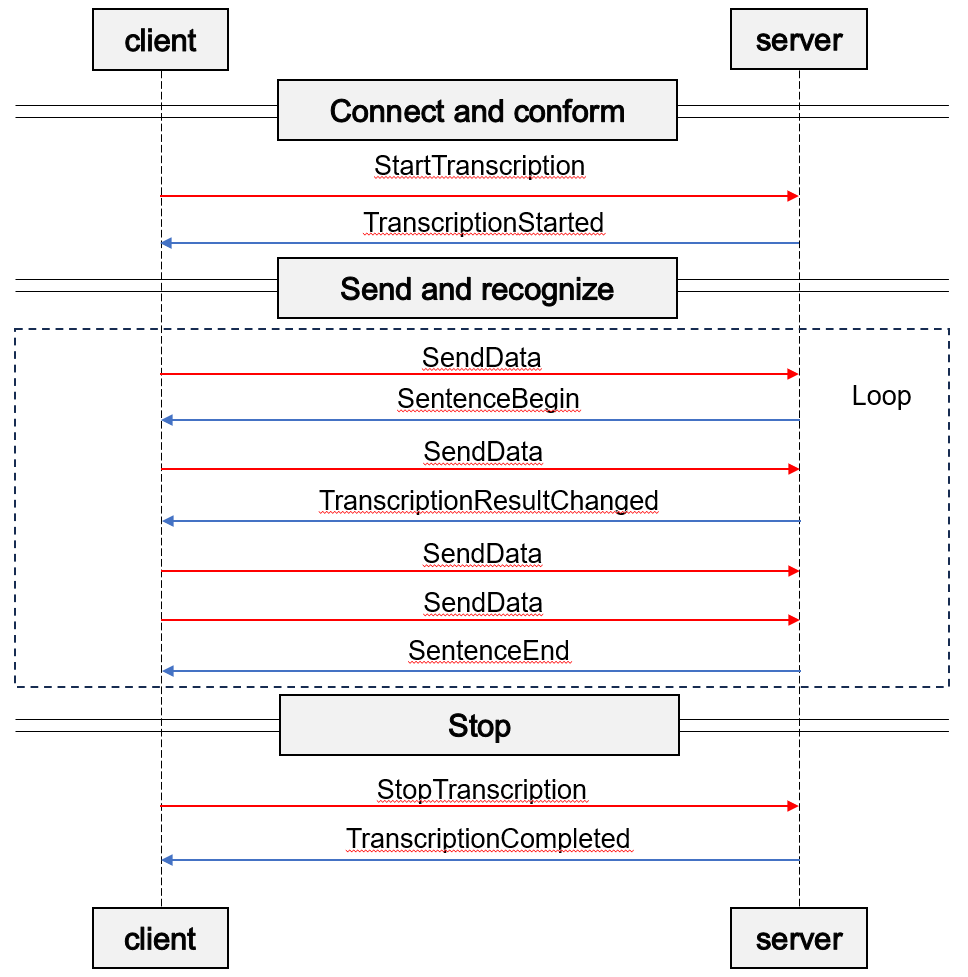
用户发送StopTranscription后,需等待服务端返回所有剩余结果。服务端会继续识别已接收到的所有数据,待所有数据处理完成并将结果返回给用户后,再断开与用户的连接。
若用户在StopTranscription后发送任何信息,服务端都会返回错误信息。
:::
交互流程说明
阶段1:建立连接并设置参数
-
客户端向服务端发送开始转录(StartTranscription)的请求,在该请求中,客户端需要指定识别过程中使用的相关参数
-
服务端收到开始转录的请求后,会进行鉴权并初始化资源,完成后向客户端发送识别开始(TranscriptionStarted)的信息。
-
以上步骤完成后,客户端可以开始向服务端发送待识别音频
阶段2:实时识别
-
客户端将音频数据以二进制的形式向服务端发送
-
服务端收到二进制音频数据后,开始进行流式识别:
-
当收到新一句话开始的音频数据后,会向客户端返回一句话开始(SentenceBegin)的信息。
-
当收到更多音频数据,直到识别的内容发生改变时,服务端会向客户端发送识别结果变化(SentenceChanged)的信息。在该结果中,服务端仅发送当前句子已被识别出的内容。注意:每次识别结果发生变化时,并不一定是多识别出了一个字,有可能是多了几个字或者是句子中之前的识别结果发生改变。
-
在识别一句话的过程中,识别结果变化的信息会发送多次
-
服务端自动检测到一句话说完后,会向客户端发送一句话识别结束(SentenceEnd)的信息。至此,一句话的内容识别完成
-
当客户端继续发送数据时,服务端会持续进行上述步骤,即循环返回一句话开始、识别结果变化、一句话识别结束
-
阶段3:停止识别
-
当客户端需要停止识别过程时,向服务端发送结束识别(StopTranscription)的请求
-
服务端停止识别并释放资源,并向客户端发送识别完成(TranscriptionCompleted)。至此整个交互过程完成。
发送请求
发送的请求主体分为文本和二进制两种格式。除发送音频数据采用二进制格式外,其余采用JSON编码的文本格式,并分为主体头(header)和主体内容(payload)两部分。
发送请求时使用相同的header格式,说明如下:
| 参数 | 类型 | 是否必选 | 说明 |
|---|---|---|---|
| appid | String | 是 | 用于说明当前的应用ID |
| type | String | 是 | 消息类型,用于区分当前请求的类型。可选的内容:“StartTranscription”, "StopTranscription" |
开始转录(StartTranscription)
开始识别,用于传输相关配置。其header部分如上所述,payload部分说明如下
| 参数 | 类型 | 是否必选 | 说明 |
|---|---|---|---|
| domain | String | 否 | 识别领域。默认为general(通用场景) |
| language | String | 否 | 语种。默认为cn(中文) |
| format | String | 否 | 音频编码格式,默认是无压缩、无头PCM文件,16bit采样、单声道。 可选:PCM、WAV(带头WAV文件)、OPUS、MP3、AMR、AAC 采用PCM格式时,音频需满足采样率16k、位长16bit、单声道;其他格式需满足采样率16k、单声道 |
| vocabulary_id | String | 否 | 自定义热词对应的ID。 |
| lm_id | String | 否 | 自定义语言模型对应的ID。 |
| enable_punctuation | Boolean | 否 | 是否在后处理中添加标点,默认是False。 |
| enable_itn | Boolean | 否 | 逆文本归一化,即将识别结果中的中文数字转换阿拉伯数字。默认是False。 |
| remove_disfluency | Boolean | 否 | 语气词过滤,即结果顺滑,默认是False。 |
| enable_speaker_info | Boolean | 否 | 是否开启说话人分离功能,默认是False。该功能为True时,在一句话识别结束时,返回该句子对应的说话人ID。 |
| nbest | Integer | 否 | 输出结果的nbest,默认为1 |
| show_confidence | Boolean | 否 | 是否输出置信度,默认为False |
| show_words | Boolean | 否 | 是否开启返回词级别信息,默认是False |
| show_intermediate_result | Boolean | 否 | 是否返回识别过程中间结果(SentenceChanged),默认是False |
| enable_semantic_sentence_detection | Boolean | 否 | 是否开启语义断句,默认是False。 |
| special_word_filter | String 文本化的JSON字符串 | 否 | 敏感词过滤功能,可根据实际需求开启或关闭自定义词或默认词表。默认为空字符串,该参数支持: 1. null 或 未定义:不处理 2. object:敏感词替换 3. array:敏感词替换为* |
示例
{
  "header":{
    "appid":"76e81efb964447",
    "type":"StartTranscription"
  },
  "payload":{
    "format":"pcm",
    "domain":"general",
    "language":"cn",
    "vocabulary_id":null,
    "lm_id":null,
    "enable_punctuation":true,
    "enable_itn":true,
    "remove_disfluency":true,
    "enable_speaker_info":false,
    "nbest":1,
    "show_confidence":true,
    "show_intermediate_result":true,
    "enable_semantic_sentence_detection":true,
    "special_word_filter":""
  }
}
发送音频数据(SendData)
直接发送二进制音频数据。
结束识别(StopTranscription)
在header中将name设置为"StopTranscription",payload为空
{
  "header":{
    "appid":"76e81efb964447",
    "type":"StopTranscription"
  }
}
返回信息
返回信息的主体均采用JSON编码的文本,同样分为主体头(header)和主体内容(payload)两部分。返回信息使用相同header形式,说明如下:
| 参数 | 类型 | 说明 |
|---|---|---|
| taskid | String | 用于记录本次会话的任务ID |
| type | String | 消息类型,用于区分当前响应的类型。可选的内容:“TranscriptionStarted”, ”SentenceBegin”, “SentenceChanged”, "SentenceEnd", "TranscriptionCompleted", "Warning", "Error" |
| status | Integer | 状态码,表示请求是否成功,见服务状态码 |
| status_text | String | 状态消息 |
识别开始(TranscriptionStarted)
在header中type为“TranscriptionStarted”,payload为空
示例
{
  "header":{
    "taskid":"4c0d4443fcd34567b42e028a54400e40",
    "type":"TranscriptionStarted",
    "status":1000,
    "status_text":"Success."
  }
}
一句话开始(SentenceBegin)
在header中type为“SentenceBegin”,payload格式如下:
| 参数 | 类型 | 说明 |
|---|---|---|
| index | Integer | 句子变化,从1开始递增 |
示例
{
  "header":{
    "taskid":"4c0d4443fcd34567b42e028a54400e40",
    "type":"SentenceBegin",
    "status":1000,
    "status_text":"Success."
  },
  "payload":{
    "index":1
  }
}
句子识别结果变化(SentenceChanged)
注意:
该部分内容仅在show_intermediate_result=true时才会输出
在header中type为“SentenceChanged”,payload中的字段如下:
| 参数 | 类型 | 说明 |
|---|---|---|
| index | Integer | 句子编号, 与SentenceBegin中的index对应 |
| start_time | Integer | 当前句子的开始时间,单位为毫秒。暂未实现。 |
| end_time | Integer | 当前句子已处理的时间,单位为毫秒。暂未实现。 |
| result | List | 当前句子的识别结果,当nbest=1时,List仅包含一个元素,当nbest>1时,包含top N结果 |
每个result元素包含以下内容:
| 参数 | 类型 | 说明 |
|---|---|---|
| text | String | 当前句子的识别结果。 |
| confidence | Double | 当前句子识别结果的置信度,取值范围:[0.0,1.0]。值越大表示置信度越高。暂未实现。 |
| words | List | 词级别信息。该部分仅在show_words=true时才会输出。暂未实现。 |
每个词级别信息包含以下内容:
| 参数 | 类型 | 说明 |
|---|---|---|
| text | String | 词的文本 |
| start_time | Integer | 词的开始时间,单位为毫秒 |
| end_time | Integer | 词的结束时间,单位为毫秒 |
示例
{
  "header":{
    "taskid":"4c0d4443fcd34567b42e028a54400e40",
    "type":"SentenceChanged",
    "status":1000,
    "status_text":"Success."
  },
  "payload":{
    "index":1,
    "start_time":0,
    "end_time":1135,
    "result":[
      {
        "text":"摩尔线",
        "confidence":0,
        "words":[
          {
            "text":"摩",
            "start_time":430,
            "end_time":870
          },
          {
            "text":"尔",
            "start_time":870,
            "end_time":990
          },
          {
            "text":"线",
            "start_time":990,
            "end_time":1135
          }
        ]
      }
    ]
  }
}
一句话识别结束(SentenceEnd)
在header中type为"SentenceEnd",payload字段如下:
| 参数 | 类型 | 说明 |
|---|---|---|
| index | Integer | 句子编号, 与SentenceBegin中的index对应。 |
| start_time | Integer | 当前句子的开始时间,单位为毫秒。当静音过长时,返回的句子内容为空,此时结果中不包含开始时间。 |
| end_time | Integer | 当前句子的结束时间,单位为毫秒。当静音过长时,返回的句子内容为空,此时结果中不包含结束时间。 |
| speaker | Integer | 当前句子对应的说话人ID。仅当enable_speaker_info=True是有效。暂未实现。 |
| result | List | 当前句子的识别结果,当nbest=1时,List仅包含一个元素,当nbest>1时,包含top N结果 |
每个result元素包含以下内容:
| 参数 | 类型 | 说明 |
|---|---|---|
| text | String | 当前句子的识别结果。当静音过长时,返回的句子内容为空字符串。 |
| confidence | Double | 当前句子识别结果的置信度,取值范围:[0.0,1.0]。值越大表示置信度越高。暂未实现。 |
| words | List | 词级别信息。该部分仅在show_words=true时才会输出。当静音过长时,返回的词信息为空列表。 |
每个词级别信息包含以下内容:
| 参数 | 类型 | 说明 |
|---|---|---|
| text | String | 词的文本 |
| start_time | Integer | 词的开始时间,单位为毫秒 |
| end_time | Integer | 词的结束时间,单位为毫秒 |
示例
{
  "header":{
    "taskid":"4c0d4443fcd34567b42e028a54400e40",
    "type":"SentenceEnd",
    "status":1000,
    "status_text":"Success."
  },
  "payload":{
    "index":1,
    "start_time":0,
    "end_time":1430,
    "speaker":0,
    "result":[
      {
        "text":"摩尔线程",
        "confidence":0,
        "words":[
          {
            "text":"摩",
            "start_time":430,
            "end_time":870
          },
          {
            "text":"尔",
            "start_time":870,
            "end_time":990
          },
          {
            "text":"线",
            "start_time":990,
            "end_time":1140
          },
          {
            "text":"程",
            "start_time":1140,
            "end_time":1430
          }
        ]
      }
    ]
  }
}
识别完成(TranscriptionCompleted)
在header中的type为“TranscriptionCompleted”,payload为空
示例
{
  "header":{
    "taskid":"4c0d4443fcd34567b42e028a54400e40",
    "type":"TranscriptionCompleted",
    "status":1000,
    "status_text":"Success."
  }
}
识别错误(Warning/Error)
在header中type为"Warning"或"Error",payload为空
若错误类型为"Warning",用户可以继续交互流程,连接被保持;
若错误类型为"Error",本次交互流程直接结束,连接断开。
示例
{
  "header":{
    "taskid":"4c0d4443fcd34567b42e028a54400e40",
    "type":"Error",
    "status":3002,
    "status_text":"service timeout"
  }
}
示例代码
Python
使用前先安装MT ASR的python库
pip install mtasr示例代码:https://github.com/yiliu-mt/mtasr_examples/tree/main/realtime_streaming_asr
具体使用方法见README
C++
代码编译与使用说明:
https://github.com/yiliu-mt/mtasr_examples_cpp
语音转换(Non-streaming)
HTTP API:http://api.mthreads.com
支持音色
| 音色 | 性别 | voice_name |
|---|---|---|
| 晓凌 | 女 | xiaoling |
| babyX | 男 | babyx |
| Boy-Ten | 男 | boy-ten |
使用限制
| 注意项 | 说明 | |
|---|---|---|
| 功能 | 限制说明 | 避免直接拼接json文本,尽量使用转换库,避免造成转义符等导致json格式错误 |
| 输入 | 音频格式支持 | 当前仅 wav 格式 |
| 音频编码建议 | 采样率大于等于16kHz,单通道,否则将进行自动转码,可能带来效果损失和更多耗时处理 | |
| 音频时长限制 | 小于30s;建议大于1s,否则会影响算法效果 | |
| 音频大小限制 | 小于等于28MB | |
| 输出 | 结果格式 | 默认输出48kHz,单通道,16bit 整型 wav 格式音频 |
接口说明
/vc/api/v1/voices
返回当前音色列表&元数据
请求参数
无
返回结果
[
  {
    "voice_id": "xiaoling",
    "nickname": "晓凌",
    "voice_type": "甜美女声",
    "gender": "Female",
    "avatar_url": "/static/img/sweet_female.png",
  }
]
/vc/api/v1/generate
对指定目标音色进行语音转换
请求参数
http请求包括两部分参数:
-
payload:在该字段内制定请求音频的相关配置,包括(voice, encoding, rate, source_encoding等) -
data字段为将音频二进制文件按照 base64 格式编码(标准base64,RFC 4648)的文本
| 字段 | 含义 | 层级 | 格式 | 必需 | 备注 |
|---|---|---|---|---|---|
| payload | 音频相关配置 | 1 | dict | ✓ | |
| voice | 发音人 | 2 | string | ✓ | |
| encoding | 输出音频编码格式 | 2 | string | 仅支持wav | |
| rate | 输出音频采样率 | 2 | int | ✓ | 仅支持48000 |
| source_encoding | 输入音频编码格式 | 2 | string | wav,默认 wav | |
| data | 二进制数据,标准base64编码 | 1 | string | ✓ |
返回结果
-
正常:
-
HTTP status code 是 200
-
content 返回二进制音频数据。
-
-
错误:
-
HTTP status code 非 200
-
content 返回 error message。
-
错误码
| HTTP状态码 | 错误信息 | 错误说明 | 排除方法 |
|---|---|---|---|
| 400 | field [payload] is not in request | 缺少了必须字段 | 检查请求json字段 |
| 400 | voice [XXX] is not valid..., supported voices ['xiaoling', 'liugenghong'] | 发音人设置无效 | 检查请求json字段 |
| 400 | source_encoding [pcm] is invalid, it must be set as [wav] in payload | 输入音频格式不正确,目前服务仅支持wav | 检查请求json字段 |
| 400 | failed to parse wav input data | 输入数据错误,数据格式和指定source_encoding不符 | 检查请求中的data字段,是否为标准wav格式以及正确编码 |
| 400 | invalid input audio (sample rate 8000 < 16000) | 音频采样率/文件大小/时长 超过限制 | 参考“相关参数-使用限制”进行调用调用 |
| 500 | There is an internal error:XXX(XXXX),\nDetails: \nXXX | 服务内部错误 | 联系服务技术支持人员进行排查 |
示例代码
import requests
import base64

api_address = "http://ip:port/vc/api/v1/generate"

with open("demo.wav", "rb") as f:
    data = f.read()
    data = base64.b64encode(data).decode('utf-8')

audio_config = {
    "voice": "xiaoling",
    "encoding": "wav",  # 输出 format,默认 wav
    "rate": 48000,  # 输出 采样率,仅 48000
    "source_encoding": "wav",  # 输入 format,默认 wav
}

request_payload = {
    "payload": audio_config,
    "data": data
}
resp = requests.post(api_address, json=request_payload, timeout=(3, 30))

if resp.status_code == 200:
    print("Save converted wav content to {}".format("demo_out.wav"))
    open("demo_out.wav", "wb").write(resp.content) # 将收到的音频写入demo_out.wav文件
elif resp.status_code == 400:
    print("Received a client error! [{}]".format(resp.content))
elif resp.status_code == 500:
    print("Received a server error! [{}]".format(resp.content))
else:
    print("Received a unknown status code [{}] with content [{}]".format(resp.status_code, resp.content))
语音转换(Streaming)
Grpc Endpoint
api.mthreads.com:53966
支持音色
| 音色 | 性别 | voice_name |
|---|---|---|
| 晓凌 | 女 | xiaoling |
使用限制
| 注意项 | 说明 | |
|---|---|---|
| 输入 | 音频格式支持 | 当前仅支持无头s16le编码的wav格式 (LINEAR16) |
| 音频编码建议 | 当前仅支持采样率16kHz,单通道 | |
| 音频时长 | 无限制 | |
| 输出 | 结果格式 | 当前仅支持输出48kHz,单通道,s16le格式的无头wav音频 |
Proto
参数说明
发送请求
-
开始转换,配置参数
| 字段 | 层级 | 类型 | 说明 |
|---|---|---|---|
| voice | 1 | string | 目标音色名称 |
| input_info | 1 | dict | 输入音频信息 |
| sample_rate | 2 | integer | 输入音频采样率,仅支持16000 |
| channels | 2 | integer | 输入音频通道数,仅支持1 |
| audio_encoding | 2 | string | 输入音频编码格式,仅支持"LINEAR16",表示无头s16le编码的wav格式 |
| output_info | 1 | dict | 输出音频信息 |
| sample_rate | 2 | integer | 输出音频采样率,仅支持48000 |
| channels | 2 | integer | 输出音频通道数,仅支持1 |
| audio_encoding | 2 | string | 输出音频编码格式,仅支持"LINEAR16" |
-
发送语音数据
| 字段 | 层级 | 类型 | 说明 |
|---|---|---|---|
| data_type | 1 | enum | 枚举类型,表示当前数据是否为最后一包。 NORMAL_CHUNK:表示音频中间包 LAST_CHUNK:表示为最后一包 |
| audio_data | 1 | bytes | 二进制格式的音频数据,需要符合与配置中source_info相符 |
-
结束转换
断开gRPC链接
接收响应
| 字段 | 层级 | 类型 | 说明 |
|---|---|---|---|
| status | 1 | enum | 枚举类型,表示当前转换状态 CONFIG_OK:配置成功 CONVERSION_OK:转换成功 CONVERSION_END:转换成功,且当前为最后一包 CONFIG_FAILED:配置失败 CONVERSION_FAILED:转换失败 |
| audio_data | 1 | bytes | 转换后的二进制格式音频数据,格式与output_info相符 |
| message | 1 | string | 当前转换状态的具体说明 |
时序图
示例代码
请查看附件《stream_vc_grpc_client.zip》
:::
通过“--voice”指定目标音色
参数中“--simulate_delay”表示是否模拟用户使用时的发包间隔。如果为False,则连续发送所有数据
:::
python grpc_stream_demo.py \
  --hostname 101.200.38.222 \
  --port 61742 \
  --voice xiaoling \
  --chunk_size 500 \
  --simulate_delay true \
  --input_wav demo.wav \
  --output stream_demo_out.wav